RAG 早已过时?三代知识检索范式拆解:检索永远解决不了理解问题
搭完向量库、切好文档块、调完相似度阈值,一套标准 RAG 系统落地。可绝大多数工程师都会撞上三道无解的墙:同一个问题时而精准答出、时而答非所问;文档里明摆着的信息,向量检索死活召回不到;知识库上线半年,只是文件变多,完全没有 “自我成长” 的能力。
很多人反复优化分块策略、微调 Embedding 模型,却收效甚微。核心原因从来不是工程实现漏洞,而是第一代 RAG “查询时临时拼凑知识” 的底层设计哲学,天生缺失对知识的理解能力。
20226 年知识检索正在发生范式迁移,RAG、GraphRAG、LLM Wiki 三代方案,本质是从 “关键词匹配” 到 “关系推理” 再到 “知识编译沉淀” 的三次认知升级。看懂三代差异,做知识库选型才能避开 90% 的弯路。
一、第一代 RAG:解释器模式,只做匹配不做理解
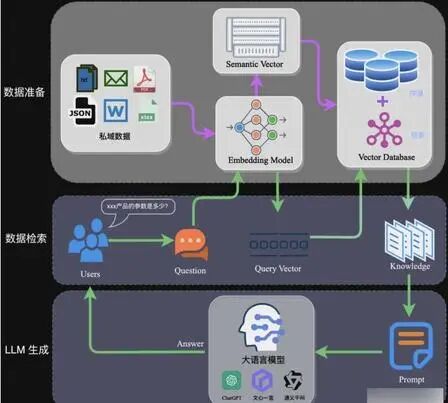
底层逻辑:查询时临时检索,无记忆、无沉淀
传统 RAG 被定义为解释器模式:所有知识处理动作,全部发生在用户提问的瞬间。
-
预处理阶段:文档切成碎片化 Chunk,转成向量存入向量数据库; -
用户提问:问题向量化,在向量库中检索相似度最高的文本片段; -
生成回答:把召回的碎片文本拼接进 Prompt,交给大模型总结输出。
刻在基因里的三大结构性痛点
- 知识碎片化,割裂上下文
文档强制分块必然切断逻辑链。比如一份完整产品白皮书,“架构设计” 和 “性能参数” 被切到两个文本块,用户询问整体技术链路时,RAG 只能召回局部碎片,无法串联完整逻辑。 - 仅靠相似度匹配,无法识别逻辑关系
向量只能判断两段文字 “语义相近”,分不清因果、递进、对立、归属关系。当你提问 “XX 技术带来了哪些负面影响”,RAG 只会召回所有含该技术的文本,无法过滤正面描述、梳理负面因果链。 - 无状态知识,知识库只会膨胀不会进化
每次提问都是从零检索、从零推导。新增文档不会和旧知识自动融合,新旧信息冲突、重复内容、过时数据全部堆积在库内。知识库只是存储容器,不会自主整合、修正、沉淀知识,最终越用越臃肿。
适合场景
轻量级问答、单文档局部信息查询、低成本快速落地简单知识库;不适合复杂推理、跨文档关联、长期迭代企业级知识库。
主流开源框架
LangChain、LlamaIndex、Chroma 基础向量 RAG 实现
二、第二代 GraphRAG:图谱模式,补上跨文档关系推理能力
底层逻辑:摄入阶段构建实体图谱,用关系做检索
2024 年微软开源 GraphRAG,彻底弥补传统 RAG 无法关联知识的短板,属于图谱推理模式:
-
文档摄入(Ingest)阶段,提前用大模型抽取实体、实体间关系,构建知识图谱三元组; -
图谱分层处理:细粒度局部实体关联 + 全局社区摘要,分别对应精准事实查询、全局总结类问题; -
用户提问时,先定位图谱实体,沿着关系链路遍历关联节点,再召回对应文本,实现跨文档串联推理。
举个直观例子:三份文档分别写 “张三是 A 公司技术总监”“A 公司自研向量引擎”“向量引擎性能提升 10 倍”。传统 RAG 分开三份碎片,GraphRAG 会自动建立「张三 – 任职 – A 公司 – 研发 – 向量引擎 – 性能提升」完整关系链,提问 “张三主导的技术项目成果” 时,一次性串联全部信息。
优势与局限
✅ 解决 RAG 最大短板:跨文档实体关联、复杂逻辑推理、全局资料总结;❌ 仍存在核心缺陷:仅存储 “实体与关系”,不会主动整合、修正冲突知识;新增文档只能追加图谱节点,无法统一收敛成标准化知识体系,依旧做不到知识库自主成长。
主流开源项目
微软官方 GraphRAG:https://github.com/microsoft/graphrag轻量优化版 LightRAG:https://github.com/HKUDS/LightRAG极简实现 nano-graphrag:https://github.com/gusye1234/nano-graphrag
适合场景
行业复杂问答、多文档关联分析、调研报告全局总结、企业多源资料联动检索。
三、第三代 LLM Wiki:编译器模式,从检索知识升级为编译知识
底层逻辑:Ingest 阶段完成知识编译,持久化沉淀标准化知识库
Andrej Karpathy 提出的 LLM Wiki,是彻底颠覆前两代的全新范式,被定义为编译器模式—— 把知识处理工作前置到文档入库环节,而非用户提问时临时处理。完整 Ingest 编译流水线:
-
读取原始文档,大模型深度理解全文核心观点; -
检索已有 Wiki 知识库,匹配相关主题页面; -
自动校验新旧内容:合并重复信息、修正矛盾观点、补充缺失细节; -
输出标准化、结构化的 Wiki 页面持久存储,建立统一元数据索引; -
用户提问时,直接读取已整合完毕、无冲突、逻辑完整的标准化知识,无需现场拼接碎片。
和前两代最本质区别
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
简单概括:RAG 是 “需要时临时找碎片”,GraphRAG 是 “提前搭好知识关系网”,LLM Wiki 是 “提前把所有资料整理成一本不断更新的 AI 百科全书”。
解决前两代无法攻克的痛点
-
知识库真正实现 “成长”:新增资料自动和存量知识融合,冲突内容自动校验修正,不会无限堆积冗余文本; -
彻底规避检索失效:无需依赖向量相似度匹配,标准化 Wiki 页面直接提供完整、连贯的结论; -
大幅降低大模型重复计算开销:查询阶段省去碎片拼接、关系遍历、多轮摘要步骤,响应速度显著提升。
局限与适用场景
❌ 劣势:文档入库编译阶段算力开销远高于 RAG、GraphRAG,初期部署成本更高;✅ 适合场景:长期迭代企业知识库、专业领域深度知识库(医疗、法律、金融)、需要持续更新沉淀的私有知识库、追求高稳定问答效果的生产系统。
四、三代范式怎么选?一份落地选型判断标准
- 轻量化快速上线、单文档简单问答 → 选第一代基础 RAG
比如内部简易文档机器人、单份说明书查询,成本最低、开发最快。 - 多文档联动、需要复杂逻辑推理、行业分析类场景 → 选第二代 GraphRAG
比如竞品多份白皮书对比、企业多份项目档案关联查询、行业调研总结。 - 长期维护专业知识库、要求问答稳定无幻觉、知识持续迭代沉淀 → 选第三代 LLM Wiki
企业私有知识库、垂直领域专业系统、面向客户对外问答产品。
同时工程落地最优组合方案:LLM Wiki 负责底层知识编译沉淀,GraphRAG 补充深度关联推理,轻量 RAG 做实时临时文档检索,三者分层搭配兼顾性能、成本、效果。
五、总结:技术演进的核心,是从 “检索” 走向 “理解”
三代知识检索范式迭代,本质是一条清晰的进化路线:从仅匹配文字碎片(RAG)→ 识别实体关联关系(GraphRAG)→ 自主整合、收敛、理解完整知识(LLM Wiki)。
传统 RAG 所有问题的根源,是它只做 “检索” 动作,完全不具备 “理解” 能力。向量相似度只能匹配文字表层,永远无法读懂文本背后的逻辑、因果、矛盾、层级关系。
2026 年知识库赛道的分水岭已经出现:基础 RAG 会沦为入门基础方案,GraphRAG 成为中端主流,LLM Wiki 则是企业级长期系统的最终形态。未来不会再比拼 “检索召回准确率”,而是比拼知识库自主消化、迭代、沉淀知识的认知能力。
技术选型从来不是追新,而是匹配业务生命周期:短期快速验证选 RAG,中期多资料联动选 GraphRAG,长期深耕垂直领域直接布局 LLM Wiki。
你正在落地哪一代知识库方案?踩过哪些检索失效、知识冲突的坑?欢迎留言讨论。
#RAG 知识库 #GraphRAG #LLMWiki #大模型知识库选型 #AI 检索技术 #企业私有知识库 #大模型落地避坑
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/07/06/rag-%e6%97%a9%e5%b7%b2%e8%bf%87%e6%97%b6%ef%bc%9f%e4%b8%89%e4%bb%a3%e7%9f%a5%e8%af%86%e6%a3%80%e7%b4%a2%e8%8c%83%e5%bc%8f%e6%8b%86%e8%a7%a3%ef%bc%9a%e6%a3%80%e7%b4%a2%e6%b0%b8%e8%bf%9c%e8%a7%a3/),并保留原文链接。
还没有评论,来说两句?