碾压传统 RAG!开源神器 Hyper Extract,凭超图重构企业知识库逻辑
做知识库的人几乎都踩过传统 RAG 的坑:长篇文档切碎成几百段向量片段,回答简单问题还行,一旦问跨章节、多实体关联的复杂问题,要么答不全、要么逻辑断裂、频繁出现幻觉。
最近一款开源工具 Hyper Extract 爆火全网,号称 “全面碾压传统 RAG”,核心不靠文本切片检索,而是直接把海量文档转化为超图知识网络,复杂业务问答准确率直接甩开普通 RAG 一大截。本文拆解它底层逻辑、对比传统方案差距、附完整部署源码与落地场景,开发者、企业运营、科研从业者都能直接复用。
一、传统 RAG 为什么越来越不够用?3 个天生硬伤
先搞懂痛点,才能看懂 Hyper Extract 的革新价值。传统 RAG 的工作流程只有两步:
-
把完整文档切成固定长度文本块,转成向量存入向量库; -
用户提问后,匹配相似度最高的几块文本,拼接给大模型生成答案。
致命缺陷
- 割裂知识关联,复杂问题答不全
一份财报里 “营收、成本、子公司、政策风险” 分布在不同段落,切片检索只会抓取局部文本,无法串联多段隐藏关系,问 “政策如何影响子公司营收” 极易丢失关键逻辑。 - 文本切片丢失结构信息
合同、论文、技术手册自带层级、时间线、多主体关系,切碎后标题、段落关联全部消失,检索精度大幅下滑。 - 长文本场景幻觉泛滥
当文档上万字,Top-K 检索只能抓取少量片段,上下文信息不足,大模型容易编造不存在的数据、关系。
二、Hyper Extract 核心逻辑:用超图替代文本切片
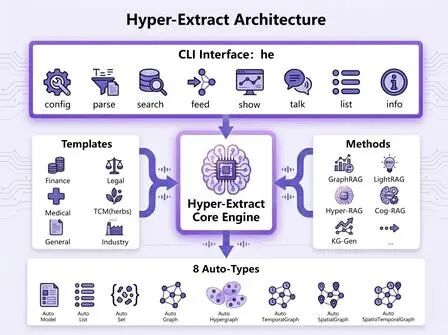
Hyper Extract 核心内置Hyper-RAG 检索引擎,抛弃 “切片向量检索” 老路,走完整文档结构化抽取路线智源社区。
三层核心架构
- CLI 交互层
全局 he命令零代码操作,支持批量解析文档、检索知识图谱、对话问答,不懂 Python 也能快速上手。 - 核心抽取引擎
内置 80 + 行业预制模板(金融、法律、医疗、工业等),自动识别文档实体、时间线、多主体关联,输出超图结构数据。 - 多范式检索层
同时兼容 GraphRAG、LightRAG、Hyper-RAG 多种检索方案,其中 Hyper-RAG 采用超图(Hypergraph) 建模,一条超边可绑定多个实体,完整保留文档里 N 元复杂关系。
关键优势对比表
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
简单说:传统 RAG 是 “碎纸机”,把文档拆成碎片;Hyper Extract 是 “建筑师”,把所有文字搭建一张互通的知识网络。
三、开源仓库与极简部署教程
项目完全开源,采用 Apache 2.0 协议,允许商用二次开发,无版权限制。
GitHub 仓库地址
https://github.com/yifanfeng97/hyper-extract国内镜像(访问加速):https://gitcode.com/yifanfeng97/Hyper-Extract
两种安装方式
-
PIP 快速安装(普通用户)
uv pip install hyperextractgit clone https://github.com/yifanfeng97/Hyper-Extract.gitcd Hyper-Extractuv sync
# 批量解析文件夹内所有PDF/MD/TXT文档he parse ./docs --template finance# 基于生成的超图知识库对话问答he talk "2025年行业政策对旗下三家子公司营收的影响"
四、4 类人群直接落地的实战场景
1. 企业研发 / 知识库工程师
替代传统向量知识库,批量解析接口文档、技术手册,自动生成组件、接口、依赖关系图谱。查询复杂系统链路问题时,不会丢失跨文档关联信息,减少大模型幻觉。
2. 金融 / 行业分析师
批量处理年报、研报,自动抽取企业、财务指标、风险、政策关联,一键生成行业知识网络,分析产业链上下游联动效率提升 5 倍以上。
3. 法律、学术科研人员
合同自动提取条款、权责关系;论文批量抓取作者、引用、核心论点,生成学术关联图谱,不用手动整理文献。
4. 个人知识管理爱好者
本地笔记、电子书批量转为 Obsidian 双链知识库,自动生成双向 wikilink,解决笔记碎片化找不到关联内容的痛点。
五、结论:RAG 技术的下一阶段,是结构化知识建模
传统切片 RAG 只是 “临时检索工具”,只适合简单单点问答;而 Hyper Extract 代表新一代检索增强思路:先结构化完整知识,再做关联检索。
对于中小团队,不用再搭建 “向量库 + 图数据库” 两套存储,单工具完成抽取、存储、问答一体化;对于大企业,可基于 Python SDK 私有化部署,对接内部业务系统搭建企业专属知识大脑。
但也要客观看待:如果你的场景只有几百字短文档、只做简单关键词问答,传统轻量 RAG 完全够用;只有处理上万字长文档、多文件跨实体复杂问答时,Hyper Extract 的优势才会完全拉开。
未来 RAG 的竞争不再是向量检索速度,而是对复杂现实知识的建模能力,超图路线大概率成为企业知识库主流方向。
你怎么看 Hyper Extract 这类超图 RAG 工具?欢迎留言讨论。
#HyperExtract #RAG 知识库 #AI 开源工具 #大模型落地 #知识图谱 #程序员 AI 工具 #企业知识库搭建
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/07/20/%e7%a2%be%e5%8e%8b%e4%bc%a0%e7%bb%9f-rag%ef%bc%81%e5%bc%80%e6%ba%90%e7%a5%9e%e5%99%a8-hyper-extract%ef%bc%8c%e5%87%ad%e8%b6%85%e5%9b%be%e9%87%8d%e6%9e%84%e4%bc%81%e4%b8%9a%e7%9f%a5%e8%af%86%e5%ba%93/),并保留原文链接。
还没有评论,来说两句?