购物车中没有产品。
74.7K 星标开源神器 Graphify:直接砍掉 71.5 倍 Token 开销,让 AI 看懂你的整套代码库
github热门推荐 › 74.7K 星标开源神器 Graphify:直接砍掉 71.5 倍 Token 开销,让 AI 看懂你的整套代码库 (第 172 章)
你有没有过这种崩溃场景:把上万行代码丢给 Claude 分析架构,对话几下就触发上下文超限;存满论文、流程图、白板截图的笔记文件夹,AI 每次查询都要重复读取全部文件,Token 账单居高不下;项目迭代半年后,自己都理不清模块之间隐藏的依赖关系。
开源工具 Graphify 给出了颠覆性解法:一行命令把代码、文档、图片全部转化为持久化知识图谱,实测混合文件场景 Token 消耗直接降低 71.5 倍,上线短短数月 GitHub 斩获 74.7K+Star,彻底改写 AI 辅助编程的工作逻辑。
一、程序员与研究者共同的 3 大行业痛点
绝大多数开发者、学术研究者,都长期被困在无结构化文件带来的低效循环里:
- 原始文件读取 Token 成本爆炸
传统 AI 编程助手没有长期结构化记忆,每次提问都需要重新读取全量文件。大型项目、多篇论文混合场景下,海量文本直接填满上下文窗口,不仅消耗巨额 Token,还容易丢失跨文件关联逻辑。 - 知识高度碎片化,跨载体无法联动
代码、PDF 论文、流程图截图、白板笔记分散存储,AI 无法自动关联 “代码实现逻辑 + 论文理论依据 + 手绘架构图”,查找跨载体关联点只能人工手动整理,维护成本极高。 - 无法区分客观事实与模型推断
普通 RAG 检索只会返回模糊文本片段,无法标注信息来源:哪些是代码里真实存在的定义,哪些是大模型自行推测的关联,一旦出现幻觉很难溯源排查。
Graphify 诞生的初衷,就是针对性解决 Andrej Karpathy 开源/raw笔记库暴露的全部痛点,用图谱结构替代线性文本存储。
二、核心优势:71.5 倍 Token 压缩到底怎么实现?
2.1 两段式解析流程,先零成本提取代码结构
Graphify 执行分为两大阶段,第一步完全不调用大模型、零 Token 消耗:使用 tree-sitter 解析 19 种编程语言源码,确定性提取类、函数、导入依赖、调用链路、注释文档,生成客观准确的代码节点与关联关系,全程无需 LLM 参与,不会产生任何模型幻觉Gitee。
2.2 多模态语义抽取,打通图文文档关联
第二阶段并行调用 Claude Vision 子代理,处理 PDF、Markdown、截图、流程图照片等非代码内容:从图片、论文里提取概念、设计动机、逻辑关系,和第一阶段的代码图谱合并,把文字、图像、代码全部收拢到同一张网络图谱中。
2.3 持久化图谱 + SHA256 缓存,重复使用零重复开销
生成 graph.json持久化图谱文件,数周后重启 AI 会话无需重读原始文件,直接复用图谱数据;内置 SHA256 文件缓存,项目迭代后仅重新解析修改过的文件,未变更内容直接复用历史图谱; 实测数据:52 个混合文件(代码仓库 + 5 篇论文 + 4 张截图)场景,单次查询 Token 消耗对比直接读取原始文件降低 71.5 倍GitHub。
2.4 置信度标签,杜绝 AI 幻觉
图谱内所有关系会标注三类标签:
EXTRACTED:文件中客观存在的真实信息 INFERRED:模型基于现有逻辑合理推导内容 AMBIGUOUS:信息模糊、无法确定的关联用户能清晰区分 “事实” 和 “推测”,解决传统 RAG 无法溯源幻觉的致命缺陷。
三、全链路多模态支持:不止代码,所有资料一网打尽
绝大多数代码分析工具仅支持源码文本,Graphify 做到真正全格式兼容:
代码文件:19 种主流编程语言,完整解析调用关系、模块依赖; 文本文档:Markdown、PDF、论文、技术推文; 图像载体:架构流程图、白板手写笔记、截图、跨语言图纸;
举个实战场景:你可以把算法论文 PDF、项目源码、手绘架构截图放进同一个文件夹,执行/graphify .后,图谱会自动串联 “论文理论公式→代码实现函数→截图架构模块” 三层关联,AI 能一次性完成跨载体逻辑推理。
四、一行命令上手,输出 4 类可复用产物
4.1 极简使用方式
适配 Claude Code、CodeBuddy、Codex、OpenClaw 等主流 AI 编程助手,安装后进入目标目录执行单行指令:
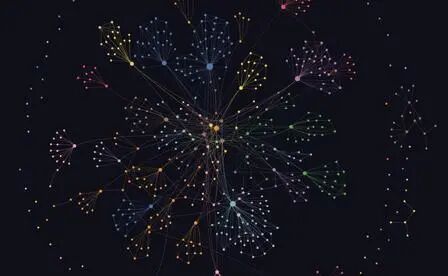
/graphify .可视化 HTML 支持缩放检索、按业务模块聚类筛选,新手也能直观看懂大型项目架构;Markdown 报告会自动标出项目 “上帝节点”(被大量模块依赖的核心底层函数),快速定位架构瓶颈。
五、快速本地部署指南
环境要求:Python3.10 及以上版本 安装 PyPI 包(包名 graphifyy)
pip install graphifyy && graphify installGitHub 开源仓库地址:https://github.com/safishamsi/graphify仓库内置中文 README 文档,支持零配置开箱即用,无数据遥测、不存在厂商锁定,所有文件本地存储不会上传第三方服务器。 AI 工具适配:以 Codex 为例,配置文件开启多代理模式即可启用图谱能力。
六、行业延伸:Graphify 预示下一代 AI 知识库趋势
- 结构化图谱将替代线性文本 RAG
传统向量检索仅能做模糊文本匹配,知识图谱可精准还原实体间逻辑链路,在代码、科研这类强关联场景效率碾压普通向量库。 - 多模态统一解析是刚需
开发者和研究者的知识载体从来不是单一文本,图文代码混合场景下,单一文本处理工具存在天然短板,Graphify 打通图像与代码的语义关联,代表未来工具标准方向。 - Token 成本优化成为刚需
随着大模型 API 定价持续走高,71.5 倍级别的 Token 压缩不只是省钱,更能突破上下文窗口长度限制,让 AI 完整理解百万行级大型项目架构。
长期来看,Graphify 的思路可以复用到产品文档、企业知识库等场景,所有碎片化资料都能通过图谱完成结构化沉淀。
总结
Graphify 解决了 AI 辅助编程两大核心痛点:昂贵的 Token 开销、碎片化无关联的知识存储。一行命令、全多模态兼容、持久化图谱缓存三大特性,让它在开源社区快速破圈。
不管是日常维护大型项目的后端工程师,还是需要频繁阅读论文复现算法的科研人员,它都能大幅降低梳理资料、理解架构的时间成本,把重复读文件的 Token 和人力,全部留给核心业务逻辑分析。
你怎么看知识图谱替代传统 RAG 做代码知识库?欢迎留言讨论。
#Graphify 开源工具 #AI 编程神器 #代码知识图谱 #大模型 Token 省钱技巧 #程序员效率工具 #多模态知识库
⚠️ 版权声明
本内容已做唯一性标记(文章 ID:516),受版权保护,未经本站书面授权,禁止任何形式的转载、复制或搬运。侵权必究,本站保留依法维权的权利。
还没有评论,来说两句?