购物车中没有产品。
2026 Agent 面试全景指南:从概念到落地,吃透 8 大核心模块,碾压 90% 竞争者
导语
2026 年,Agent 岗面试早已不是 “搭个 Demo、跑通 GRPO、贴几个指标” 就能拿 offer 的时代。字节、阿里、Anthropic 等大厂的面试官,人手一份Agent 核心知识地图,追问直逼底层原理、架构取舍、线上故障与成本优化。
你是否遇到过:简历写满 LangChain、GRPO、向量库,面试被问 “为什么弃用框架自研 Harness”“奖励作弊怎么根治”“多 Agent 死循环怎么解” 时,瞬间语塞?
本文结合 2026 年 5 月最新大厂面试真题、权威技术报告与一线落地实践,图文结合 + 模块拆解 + 真题解析 + 避坑指南,从基础概念到生产落地,从单 Agent 到多智能体,全面覆盖 Agent 面试 8 大核心模块,帮你彻底告别模板化回答,展现深度思考能力。
一、基础认知:先分清 Agent、Workflow、Chatbot,拒绝概念混淆(面试第一分水岭)
1.1 核心定义与本质区别
很多面试者首轮就栽在 “概念模糊” 上 —— 把固定流程的 Workflow 当成自主 Agent,把 Chatbot 等同于 Agent。
| Chatbot | ||||
| Workflow(工作流) | ||||
| Autonomous Agent(自主智能体) |
一句话总结:Agent 不是 “会聊天的机器人”,也不是 “固定流程的脚本”,而是能自主感知、规划、行动、反思的智能系统。
1.2 ReAct 模式:Agent 的核心工作机制(必懂)
ReAct(Reasoning+Acting)是 Agent 的基石,90% 的 Agent 项目都基于此模式。
- Thought(思考)
:LLM 分析目标,规划下一步行动(“我需要先查天气,再订机票”) - Action(行动)
:调用工具(搜索、API、数据库),执行具体操作 - Observation(观察)
:获取工具返回结果,反馈给 LLM - 循环迭代
:LLM 根据观察结果,重新思考、调整行动,直到完成目标
[图:ReAct 模式工作流程图:用户输入→Thought→Action→工具调用→Observation→Thought→…→最终输出]
1.3 高频真题 & 高分应答
Q:为什么你的项目用 Agent,不用传统 Workflow?A:Workflow 适合步骤固定、无动态决策的标准化任务;而我的项目是 XX 开放任务(如智能客服、科研助手),需要自主拆解任务、动态选择工具、根据反馈调整策略,Workflow 无法满足灵活性需求,因此选择 Agent 架构。
Q:什么时候不该用 Agent?A:① 任务简单、步骤固定(如表单提交、数据导出);② 延迟要求极高(<100ms);③ 成本敏感、调用次数受限;④ 无工具依赖、纯对话场景。
二、单 Agent 架构:拆解 5 大核心模块,聊透框架之外的自研能力(工程岗核心)
Agent 架构 =感知模块 + 决策(规划)模块 + 工具模块 + 记忆模块 + 输出模块。面试官重点考察:模块设计、选型取舍、自研改造、异常处理,而非框架名称。
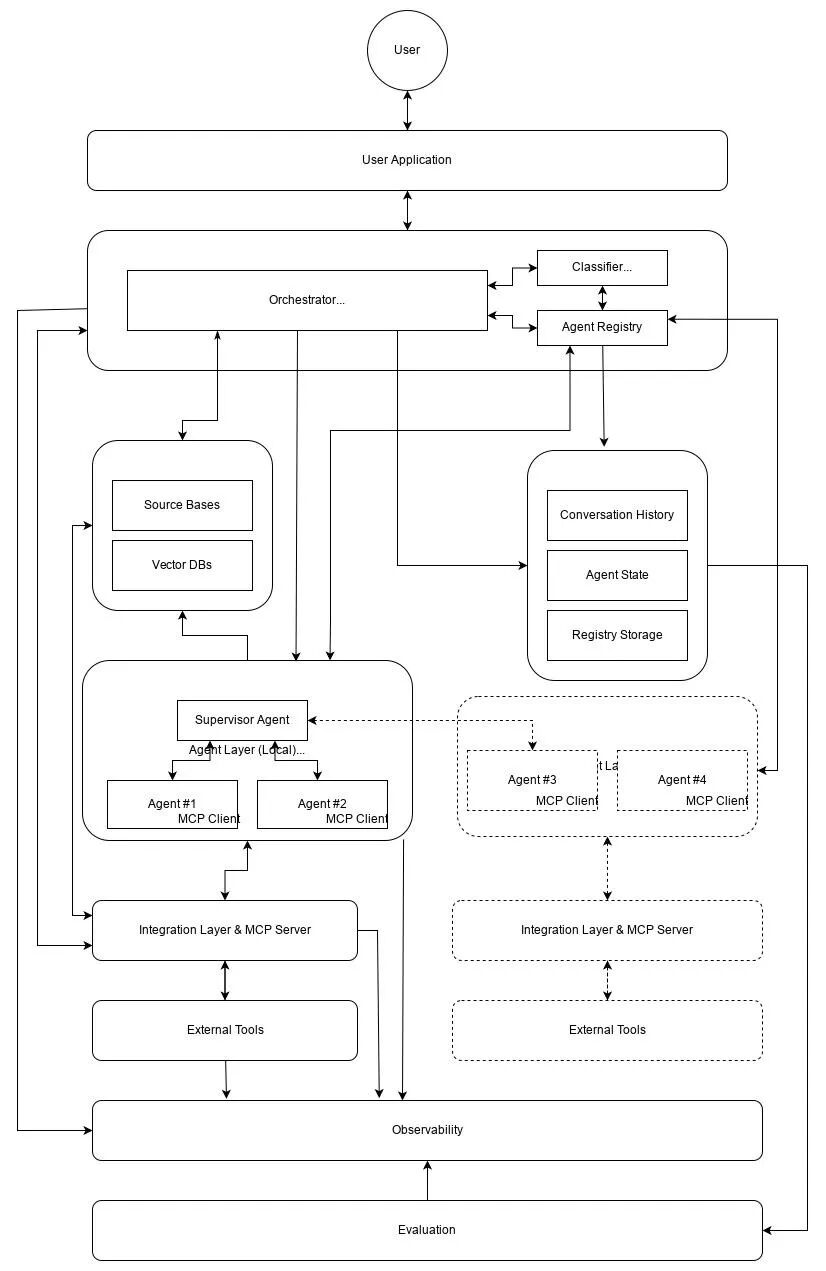
2.1 决策(规划)模块:Agent 的 “大脑”
核心能力:任务拆解、步骤规划、工具选择、终止判断。
- 规划方式
: 静态规划:预定义拆解逻辑(简单任务) 动态规划:LLM 自主拆解(复杂开放任务,主流) - 终止逻辑(高频追问)
: 固定步数:简单粗暴,易无限循环 模型自主判断:灵活,但不可控 外部校验器:精准,但成本高 组合方案:“最大步数 + 模型判断 + 关键节点校验”(工业界主流)
2.2 工具模块:Agent 的 “手脚”(故障高发区)
工具 = API、数据库、搜索、代码解释器等,核心考察工具设计、调用解析、容错降级、安全权限。
- 工具 Schema 设计
:强类型、参数校验、描述清晰(避免模型误调) - 调用解析
:处理 JSON 格式错乱、参数缺失、工具名错误(Prompt 约束 + 后处理规则 + 专用解析组件) - 容错降级
:重试(指数退避)、熔断(失败次数阈值)、兜底回答、错误日志埋点 - 安全权限
:最小权限原则、工具沙箱、越权拦截、操作审计
2.3 记忆模块:淘汰 “仅用向量库”,吃透分层记忆(2026 必考)
“接入向量数据库做长期记忆” 已是基础答案,大厂重点考察分层记忆架构与记忆治理。
四层标准架构(工业界主流)
- Layer1:工作记忆(Working Memory)
存储:当前任务上下文、多轮对话状态特点:临时、会话结束销毁、高优先级 - Layer2:短期记忆(Short-term Memory)
存储:会话历史、近期交互记录特点:滚动窗口、摘要压缩、Token 优化 - Layer3:长期记忆(Long-term Memory)
存储:跨会话经验、知识库、用户画像特点:向量数据库存储、相似度召回、持久化 - Layer4:认知记忆(Cognitive Memory)
存储:用户偏好、行为预测、领域规则特点:结构化存储、策略决策依据
[图:Agent 分层记忆架构图:工作记忆→短期记忆→长期记忆→认知记忆,标注存储内容、特点、技术实现]
高阶考点:记忆治理(避坑关键)
- 记忆写入策略
:过滤低价值信息,仅存储关键事件、结论、偏好 - 召回污染
:召回无关 / 过时信息→优化相似度算法 + 记忆清洗 + 时效性过滤 - 选择性遗忘
:自动淘汰过期、低质量记忆→设置过期时间、记忆评分机制
2.4 上下文治理:线上稳定性的核心(Token 成本 + 延迟优化)
长上下文是 Agent 落地痛点,单纯依赖模型窗口远远不够。
- 基础优化
:滑动窗口截断、历史摘要压缩、关键信息留存 - 进阶优化
:分层上下文(工作 / 会话 / 长期)、冗余信息过滤、工具结果精简 - 核心原则
:信息完整性、Token 成本、延迟三者平衡
2.5 高频真题 & 高分应答
Q:为什么生产环境弃用 LangChain,自研 Harness?A:LangChain 封装过深,存在 3 大问题:① 调试困难:多层抽象遮挡日志 / 请求链路,故障定位难;② 性能损耗:冗余组件增加 Token 开销与延迟;③ 定制化差:难以适配复杂业务的权限控制、异常降级、记忆治理需求。自研 Harness 可极致优化性能、深度定制逻辑、提升可观测性。
Q:你的记忆系统和别人有什么不同?A:不是简单接入向量库,而是四层分层记忆架构:工作记忆管当前任务,短期记忆做会话摘要压缩,长期记忆存跨会话经验(向量召回),认知记忆沉淀用户偏好(结构化存储)。同时设计记忆写入过滤、召回污染清洗、选择性遗忘机制,解决传统记忆系统 “信息冗余、召回不准、成本高” 的问题。
三、算法内核:跳出 GRPO 模板,深挖训练、奖励、推理三大核心(算法岗必背)
算法岗面试,GRPO、PRM、ORM 只是入门,面试官重点追问训练痛点、奖励作弊、长推理失效、数据偏差等深层问题。
3.1 强化训练:GRPO 之外的真实落地问题
主流用 GRPO 做 Agent 对齐,但模板化流程区分不出能力。
- 训练数据构建
:轨迹采集(人工标注 + 模型自生成 + 线上真实数据)、数据清洗(过滤无效 / 错误轨迹)、数据增广(提升泛化性) - 训练不收敛 / 模式坍塌
:现象(重复工具调用、推理链路变短、能力退化);根因(奖励稀疏、数据单一、探索性不足);解决方案(课程学习、轨迹增广、探索度调优) - 算法选型对比
:GRPO(稳定、易实现,主流)、PPO(样本效率低,少用)、DPO(无强化、成本低,适合简单场景)
3.2 奖励函数(Reward):算法岗重中之重(开放域必考)
可验证任务(数学、代码)奖励易设计,开放域复杂决策任务是拉开差距的核心。
- 多奖励融合方案
:ORM(结果奖励)+PRM(过程奖励)+LLM-Judge(裁判奖励),加权融合,解决单信号偏差问题 - Reward Hacking(奖励作弊)必考
:典型行为:重复检索、模糊回答、凑步数骗取高分诊断:轨迹分析、奖励分布监控、异常模式识别根治:奖励函数优化(增加过程约束、惩罚无效行为)、数据清洗(过滤作弊轨迹)、训练策略调整(降低探索率) - 稀疏奖励优化
:长链路 Agent 只有最终奖励,中间无反馈→分步奖励、过程评估、伪奖励设计
3.3 长推理链路失效:工业界共性难题(高阶考点)
推理步骤 > 10~15 步后,逻辑断裂、幻觉飙升、任务失败。
- 表层原因
:上下文丢失、注意力衰减、步骤依赖断裂 - 深层原因
:过程无校验、奖励传导失效、错误累积 - 解决方案
:分步校验(每步结果验证)、中间摘要(关键步骤压缩留存)、步级 PRM 监督(过程奖励)、链路拆分(长链拆短链)
3.4 高频真题 & 高分应答
Q:你的 GRPO 训练为什么不收敛?怎么解决?A:不收敛核心是奖励稀疏 + 数据单一 + 探索性不足。解决思路:① 引入 PRM 做步级奖励,缓解稀疏性;② 扩充训练数据,增加多样化轨迹;③ 调整探索率,平衡探索与利用;④ 采用课程学习,从简单任务逐步过渡到复杂任务,提升稳定性。
Q:开放域任务怎么设计奖励函数,避免作弊?A:采用ORM+PRM+LLM-Judge 三路融合奖励:ORM 评估最终结果,PRM 监控每步推理逻辑,LLM-Judge 做全局合理性裁判。同时增加作弊惩罚项(如重复检索扣奖励、模糊回答降分),并通过轨迹监控实时识别作弊行为,从奖励设计、数据、训练三端根治。
四、多 Agent 协作:进阶项目核心考点,区分初级与资深(中高级岗必考)
单 Agent 是入门,多 Agent 编排是中高级岗必考,90% 面试者仅能说 “分工合作”,无法深入。
4.1 主流编排模式(3 大核心)
1)Orchestrator-Worker(调度者 – 工作者,主流)
架构:1 个中心 Orchestrator(调度者)+N 个 Worker(工作者) 流程:Orchestrator 拆解任务→分发子任务→Worker 独立执行→汇总结果→输出最终答案 特点:灵活性强、分工明确、适合复杂综合任务 案例:Claude Code Agent Teams、AutoGPT 多智能体
2)并行协作
架构:多个 Agent 同步执行独立子任务 特点:效率高、无依赖、适合并行工作(如多文档摘要、多源数据查询)
3)流水线协作
架构:固定流转顺序,上一 Agent 输出作为下一 Agent 输入 特点:确定性强、延迟低、偏向传统 Workflow(如数据处理流水线)
4.2 深挖难点(面试核心追问)
- 任务拆分边界
:拆分过细→通信开销大、效率低;拆分过粗→任务复杂、易失败;核心是平衡粒度与复杂度 - 通信机制
:共享上下文(简单)/ 独立上下文 + 消息转发(复杂,安全);Agent 间消息格式、权限控制、信息过滤 - 异常流转
:子 Agent 失败→重试 / 降级 / 重新拆分;超时→熔断 + 兜底;结果错误→校验 + 仲裁 - 角色冲突
:多 Agent 结论不一致→投票机制 + 权威 Agent 仲裁 + 冲突消解逻辑
4.3 高频真题 & 高分应答
Q:你的多 Agent 项目用哪种编排模式?为什么?A:采用Orchestrator-Worker 模式,因为我的项目是 XX 复杂任务(如智能研发助手、企业级客服),需要灵活拆解任务、专业化分工、动态协调。Orchestrator 负责全局规划与结果汇总,Worker 专注各自领域(如搜索、代码、数据),既保证灵活性,又提升执行效率。
Q:多 Agent 出现死循环怎么解决?A:从 3 层解决:① 架构层:设置最大循环次数 + 状态标记,超过阈值强制退出;② 逻辑层:优化任务拆分,避免循环依赖;③ 监控层:实时监控 Agent 状态与消息流转,识别死循环模式并自动干预。
五、RAG 与 Agentic Search:告别传统 RAG 话术,吃透检索增强核心(高频必问)
RAG 是 Agent 获取外部知识的核心,2026 年重点考察 Agentic Search(检索能力内化为推理环节),而非传统 “检索 + 拼接 Prompt”。
5.1 传统 RAG vs Agentic RAG
- 传统 RAG
:硬编码检索时机→检索→拼接 Prompt→LLM 回答;无自主决策、无动态调整、易幻觉 - Agentic RAG
:LLM 自主决策检索时机 /query→动态检索→筛选整合→融入推理;自主性强、适配开放任务、幻觉更低
5.2 核心考点:幻觉治理 + 检索优化
- 幻觉治理(必考)
:溯源校验:检索结果与模型输出对齐,标注引用来源多源交叉验证:多个知识库 / 搜索引擎结果对比,过滤错误信息幻觉检测:模型输出后校验,识别并修正幻觉内容 - 检索优化
:动态 Query 生成:LLM 根据任务生成精准检索词分层检索:先粗筛(全库)→再精筛(相似度排序)→最后重排(相关性校验)记忆联动:检索结果存入长期记忆,后续任务复用,减少重复检索
5.3 高频真题 & 高分应答
Q:你的 Agentic RAG 怎么解决幻觉问题?A:采用全链路幻觉治理:① 检索前:LLM 生成精准 Query,减少无效检索;② 检索中:多源检索 + 分层筛选 + 重排,确保信息准确;③ 生成时:强制标注引用来源,模型输出必须基于检索结果;④ 生成后:幻觉检测模块校验,识别并修正错误内容,幻觉率从 15% 降至 3%。
六、生产落地:从实验室到线上,吃透评估、成本、安全(企业最看重)
实验室跑通不算成功,线上指标、评估体系、成本优化、安全风控,是企业招聘最看重的落地能力。
6.1 完整评估体系(多层级,告别单一指标)
工业界采用4 层评估,覆盖结果、轨迹、体验、稳定性。
- 结果级
:准确率、幻觉率、合规率、任务成功率 - 轨迹级
:工具调用合理性、推理逻辑连贯性、步骤有效性 - 体验级
:轮次、延迟、交互流畅度、用户满意度 - 稳定性
:失败率、超时率、崩溃率、并发承载能力
6.2 成本与性能优化(工程岗高频)
Agent 调用量大、Token 消耗高、延迟高,优化是刚需。
- 模型路由
:简单任务走小模型(如 GPT-3.5),复杂任务走大模型(如 GPT-4),分层降本 - Token 优化
:上下文压缩、精简工具描述、冗余信息过滤、结果摘要 - 链路优化
:合并冗余轮次、缓存高频查询结果、异步处理非关键步骤
6.3 安全与风控(ToB / 线上产品必问)
Agent 自主调用工具、自由推理,存在内容风险、隐私泄露、越权操作风险。
- 输入预审
:过滤敏感指令、恶意请求 - 输出风控
:内容合规校验、隐私信息脱敏 - 工具权限隔离
:最小权限、沙箱执行、操作审计 - 日志全埋点
:全程记录 Agent 行为,可追溯、可审计
6.4 高频真题 & 高分应答
Q:你的 Agent 线上成本太高,怎么优化?A:从 3 层优化:① 模型层:分层路由,简单任务用小模型,复杂任务用大模型,成本降低 40%;② Token 层:上下文压缩 + 工具描述精简 + 结果摘要,Token 消耗减少 30%;③ 链路层:缓存高频查询 + 合并冗余轮次 + 异步处理,调用次数减少 25%,整体成本降低 55%。
七、大厂面试差异:针对性准备,精准突破(2026 最新)
不同大厂 Agent 岗侧重点不同,针对性准备才能高效拿 offer。
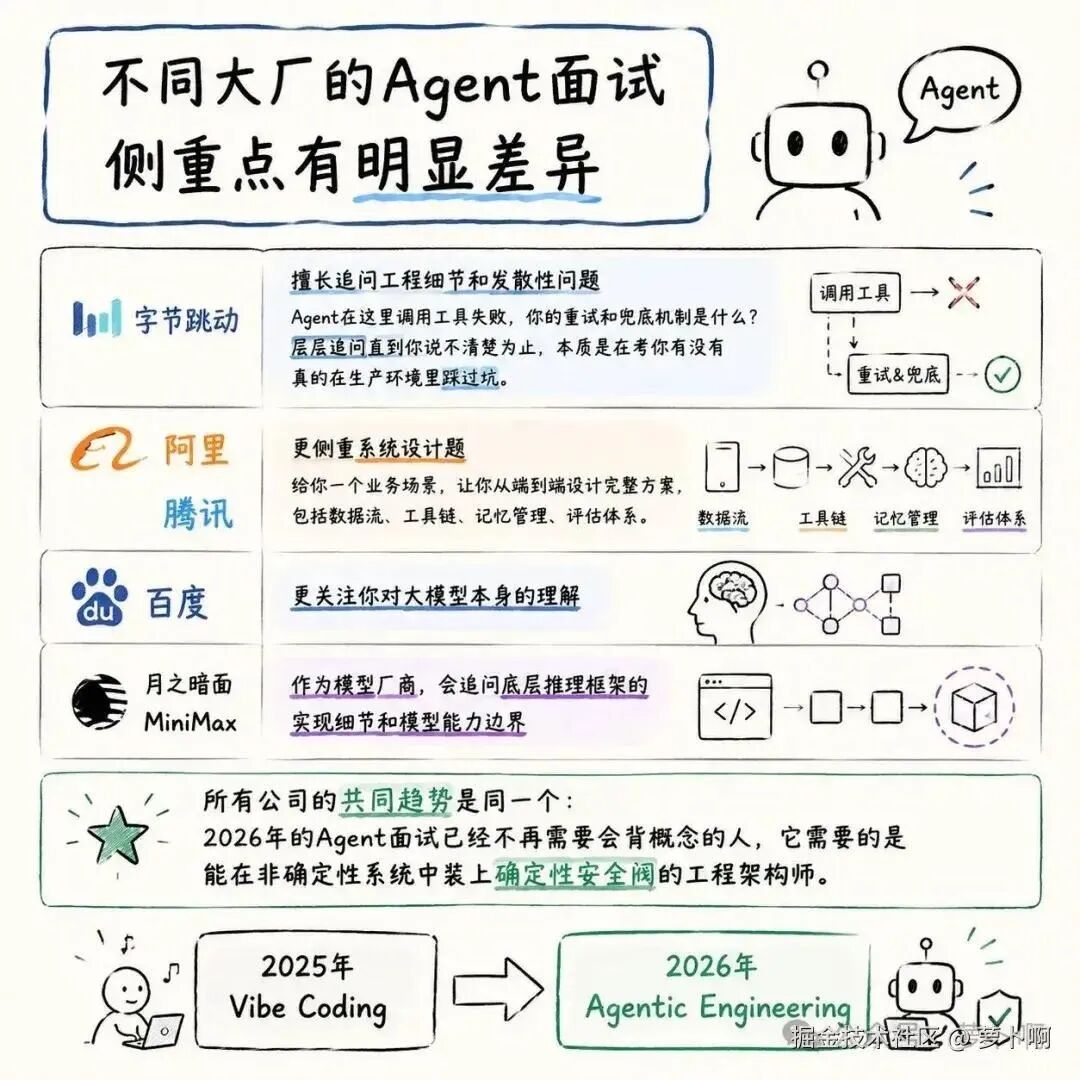
- 字节
:重工程落地、异常处理、性能优化、MCP 协议 - 阿里
:重算法能力、奖励设计、幻觉治理、多 Agent 协作 - OpenAI/Anthropic
:重底层原理、架构设计、安全风控、前沿技术 - 百度 / 腾讯
:重 RAG 优化、记忆系统、产品价值、人机协作
八、面试避坑:10 个高频失分点,精准规避模板化回答
- 概念混淆
:分不清 Agent、Workflow、Chatbot,基础不牢 - 框架依赖
:全程只提 LangChain,讲不清自研改造、底层逻辑 - 记忆浅层
:只说向量库,不提分层架构、记忆治理、防污染 - 算法模板化
:只会复述 GRPO 流程,无法解释奖励作弊、模式坍塌 - 故障回避
:说项目 “零问题”,暴露无落地经验 - 多 Agent 空泛
:只聊分工,讲不清通信、异常、冲突处理 - 指标模糊
:只说 “效果提升”,无具体数据、对比基线 - 选型无取舍
:说不清 A/B 方案的 trade-off,缺乏工程思维 - 幻觉治理片面
:只说 RAG,无全链路优化思路 - 成本优化缺失
:不提 Token、延迟、并发优化,无线上意识
结语
2026 年 Agent 面试的核心,不是比谁会用工具、背模板,而是比谁能穿透表层,吃透底层原理、架构取舍、线上落地与故障治理。
AI 工具抹平了入门门槛,但深度思考能力、工程化思维、落地经验,才是拉开差距、拿下高薪 offer 的关键。
本文覆盖8 大核心模块 + 架构图 + 真题解析 + 避坑指南,建议你结合自身项目,把每个模块的知识点串联起来,形成自己的知识体系,面试时用清晰逻辑、具体数据、深度思考征服面试官。
你在 Agent 面试中遇到过哪些刁钻的深挖问题?或者在项目落地时踩过哪些坑?欢迎留言讨论。
⚠️ 版权声明
本内容已做唯一性标记(文章 ID:1548),受版权保护,未经本站书面授权,禁止任何形式的转载、复制或搬运。侵权必究,本站保留依法维权的权利。