狂省 70 万美元、释放 2000 亿 Token!Netflix 开源 Headroom,根治 AI 账单黑洞
一、AI 账单失控的根源:90% 上下文全是 “无效垃圾”
很多企业做 AI Agent 时陷入误区:只关心模型调用能力,完全忽略上下文里的冗余开销。日常开发里,三类场景会疯狂吞噬 Token:
- 数据库 / 工具返回结构化 JSON
:接口返回成千上百行数据,80% 字段是重复元数据、无关历史记录; - 运维日志、长文本文件
:日志充斥固定模板、重复报错堆栈,有效信息不足 10%; - RAG 多轮检索 + 多轮对话
:每一次工具调用都会把完整历史上下文重新传给模型,Token 消耗指数级上涨。
Tejas Chopra 统计过一组残酷数据:绝大多数企业发给 LLM 的 Token 里,60%-90% 内容对模型回答毫无帮助,等于纯纯在给云厂商交 “信息垃圾税”。
过去行业传统解法只有两种,各有硬伤:
-
粗暴截断上下文:直接砍掉后半段文本,极易丢失关键信息,导致 AI 输出错误; -
前置摘要压缩:用小模型先总结内容,额外产生一轮 Token 消耗,长文本摘要还会丢失细节。
Headroom 的核心思路完全不同:不截断、不摘要,可逆式无损压缩冗余信息,从源头减少进入大模型的数据量。
二、拆解 Headroom:6 大算法 + 可逆缓存,做到最高 95% Token 削减
1. 整体架构:透明代理层,不用改动现有 Agent 代码
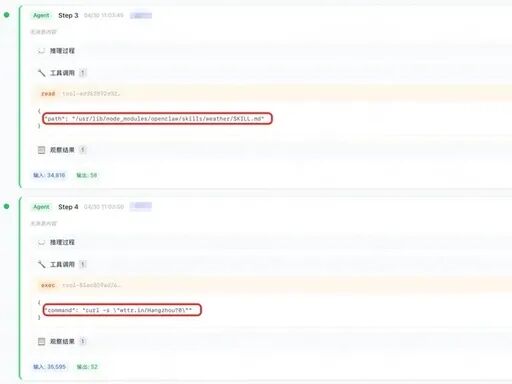
Headroom 定位是应用与 LLM API 之间的中间代理,部署逻辑极简:
-
Agent 照常发送完整日志、数据库、检索文本; -
Headroom 拦截全部上下文,自动识别内容类型; -
匹配专属压缩算法瘦身,把精简后内容转发给大模型; -
内置 CCR 可逆缓存,模型需要原始完整数据时一键调取。
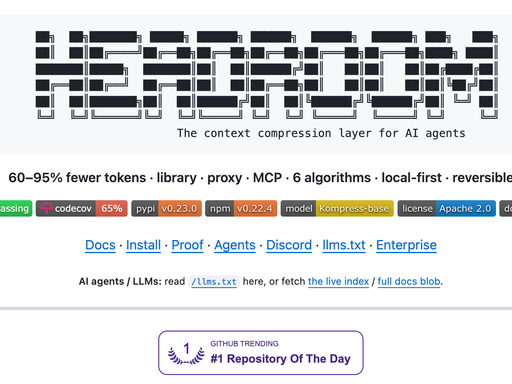
项目开源地址:https://github.com/chopratejas/headroom开源协议为 Apache 2.0,企业商用无版权限制,支持库集成、独立代理、MCP 协议三种接入模式。
2. 六大自适应压缩算法,针对性处理不同数据
它内置 6 套专用压缩引擎,自动路由匹配内容,而非一刀切压缩:
- SmartCrusher(JSON 结构化压缩)
工具调用最常用,自动剔除重复字段、过滤低权重元数据,通过 BM25 + 向量混合算法保留高相关性数据,结构化数据 Token 平均缩减 75%; - CodeCompressor(AST 语法树代码压缩)
业内少见的语法感知压缩,支持 Python/Go/Java/C++ 等 6 门语言。只保留类、函数签名、导入依赖等骨架,压缩函数内部重复实现逻辑,代码场景 Token 最高削减 92%; - Kompress-base(通用文本压缩)
面向普通文档、对话历史,剔除重复句式、填充型虚词,保留完整语义; -
LogCrusher(日志专用压缩)、FilePruner(文件精简)、DialogSlimmer(多轮对话瘦身)分别适配运维日志、本地文件、长对话场景,覆盖企业 Agent 全链路数据源。
3. 核心黑科技:CCR 可逆缓存,告别信息丢失焦虑
这是 Headroom 区别于所有压缩工具的创新点。普通压缩要么删数据、要么永久改写文本,而 CCR(压缩 – 缓存 – 取回)机制会把完整原始数据本地缓存,压缩文本内仅留存简短索引标记。当大模型推理过程需要原始完整内容时,可通过标记反向调取缓存里的全量数据,全程不丢失任何细节,彻底规避 “压缩后 AI 答错业务问题” 的风险。
同时工具主打本地优先,所有缓存、压缩计算在企业本地完成,不会把业务原始数据上传第三方,满足数据安全合规要求。
三、真实落地数据:个人账单砍半,企业累计省 70 万美元
Tejas Chopra 在开源峰会上公布了真实落地数据,说服力极强:
- 个人测试场景
:使用 Headroom 后,单月 Claude 账单从 287 美元降至 110 美元,输出准确率无任何下降; - 全球用户汇总(截至 2026 年 6 月)
-
累计节省 AI 调用成本:70 万美元; -
累计减少无效 Token 消耗:2000 亿个; -
通用业务场景平均压缩率:70%;代码、日志场景可达 90%-95%。
虽然 Headroom 只是工程师个人侧项目,并非 Netflix 官方产品,但公司内部多个 SRE、数据分析团队已全面接入,用来处理海量运维日志 Agent;外部金融、云服务、AI 创业公司也批量落地,上线不久就登顶 GitHub 当日趋势仓库。
四、不止是省钱工具:它暴露 AI 行业计费逻辑的底层变革
Headroom 爆火的背后,藏着一个容易被忽略的行业趋势:AI 的成本管控正在从 “事后对账” 转向 “前置拦截”。
-
过去大家关心 “大模型单价多少”,现在所有人都在抠 “如何少传无用 Token”随着 Agent 深度落地,工具调用、RAG 检索、长上下文对话成为标配,输入 Token 开销早已超过输出,压缩上下文的收益远低于换低价模型; -
AI 成本治理分层成型:监控告警(事后)→预算熔断(事中)→上下文压缩(事前)Headroom 补齐了最关键的前置优化环节,三者搭配才能搭建完整的企业 AI 成本体系; -
行业共识转变:冗余 Token 本质是技术浪费,而非不可避免的开销之前很多团队默认 “多传数据总没错”,现在意识到无意义文本只会拉高成本、挤占上下文窗口,甚至触发模型输入长度限制。
长远来看,这类上下文压缩工具会成为企业 Agent 开发的基础设施,就像现在的 API 网关、缓存中间件一样标配部署。
五、总结:企业落地的 3 个行动建议
-
先做场景试点:优先接入日志分析、代码查询、数据库查询类 Agent,这类场景压缩收益最高,能快速验证成本节省效果; -
三层成本管控搭配使用:Headroom 前置压缩 + Token 用量实时监控 + 会话级预算熔断,三重防线杜绝账单失控; -
优先本地部署:利用 local-first 特性,业务敏感数据不离开内网,兼顾降本与数据安全。
一款个人开源项目能短短数月帮用户省下百万美元,足以证明当下 AI Agent 的成本漏洞有多普遍。与其被动承受不断上涨的 Token 账单,不如从源头精简无效上下文。
你怎么看这款 Token 压缩工具?欢迎留言讨论。
抖音话题
#AI 成本优化 #Headroom #Netflix 开源 #AIAgent #大模型 Token 省钱技巧 #程序员开源神器
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/06/19/%e7%8b%82%e7%9c%81-70-%e4%b8%87%e7%be%8e%e5%85%83%e3%80%81%e9%87%8a%e6%94%be-2000-%e4%ba%bf-token%ef%bc%81netflix-%e5%bc%80%e6%ba%90-headroom%ef%bc%8c%e6%a0%b9%e6%b2%bb-ai-%e8%b4%a6%e5%8d%95%e9%bb%91/),并保留原文链接。
还没有评论,来说两句?