购物车中没有产品。
τ0-WM | 砸下 17800 小时真机数据,中国开源模型改写具身智能游戏规则
github热门推荐 › τ0-WM | 砸下 17800 小时真机数据,中国开源模型改写具身智能游戏规则 (第 86 章)
当所有人都觉得,机器人的真机数据是 “奢侈品”,只能在最后微调阶段用一点点时,智元团队直接砸了17800 小时—— 相当于一台机器人连续两年、24 小时被人类遥操作的真实数据,做了一次前无古人的预训练。
这不是炫富,而是在改写具身智能的底层逻辑:原来,机器人的 “想象力” 和 “执行力”,可以靠大规模真实数据一起练出来。
一、打破常识:把 “奢侈品数据” 用在预训练阶段
行业里默认的路径是:仿真环境先训模型,最后用少量真机数据微调。因为真机数据太难搞、太贵了,没人敢拿来做大规模预训练。
但 τ0-WM 直接反着来:
总数据量约3 万小时,其中1.78 万小时是真实机器人遥操作数据,占比超一半 剩下的是开源演示数据和人体交互视频,做补充和泛化 参数量达5B,是目前全球规模最大的开源预训练具身世界模型
17800 小时真机数据(蓝色)、6500 小时开源演示数据(黄色)、3000 小时人体交互视频(灰色)
这就像别人学开车,只敢用模拟器练,最后上车只敢跑两圈;而你直接拿了两年的真实上路录像,把每一次刹车、转弯、避让都刻进了模型的 “肌肉记忆” 里。
二、不止 “看动作”,更能 “预演未来”
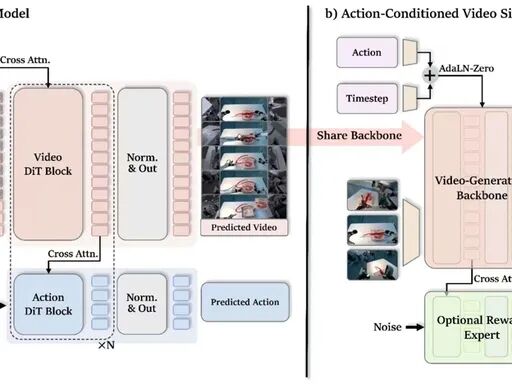
τ0-WM 的核心,是一个统一的视频 – 动作世界模型。它不只是学 “人做了什么动作”,更要学 “这个动作会导致什么结果”。
它的能力分成了三个关键模块:
- 动作预测
:根据当前画面,预测机器人接下来该做什么动作 - 未来模拟
:像人类一样在脑子里 “预演” 动作执行后的画面 - 动作优化
:从预演结果里,筛选出成功率最高的方案
简单说,以前的机器人是 “边做边看”,做错了再补救;现在的机器人,能先在脑子里把任务 “走一遍流程”,挑出最稳的方案再动手。
[图:τ0-WM 模型架构示意图:输入视频 / 动作 → 共享扩散骨干网络 → 输出未来视频预测 + 最优动作序列]
三、效果说话:400 条数据就能搞定精细操作
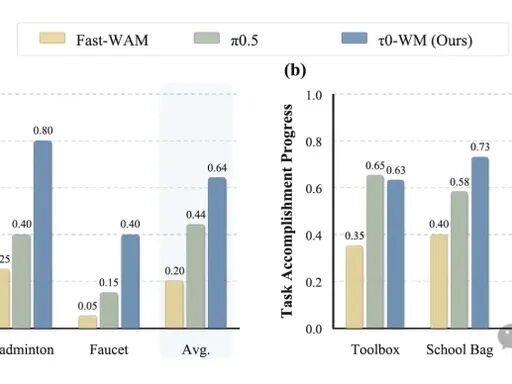
预训练的价值,在下游任务里直接体现出来了。在收纳羽毛球、精细装配这类任务上,τ0-WM 展现出了惊人的 “举一反三” 能力:
仅需400 条示范数据,就能学会收纳羽毛球这类精细任务 成功率超越了同场景下的其他基准模型,甚至能跨不同机器人本体迁移
这背后的逻辑很清晰:预训练阶段的大规模数据,让模型学到了 “物理世界的通用规律”。就像人学会了 “物体受力会运动” 的常识,换个工具、换个场景,也能快速上手。
[图:任务成功率对比柱状图:τ0-WM vs 其他主流模型,标注关键任务的成功率提升幅度]
四、为什么这一步这么关键?
具身智能火了快两年,大家都卡在一个核心问题上:怎么让机器人在真实世界里,又稳又快地学会新任务?
仿真训练出来的模型,一到现实里就 “水土不服”,因为真实世界的摩擦力、光照、误差,永远比模拟器复杂 少量真机微调,又很难覆盖所有场景,换个杯子、换个桌子,模型就懵了
τ0-WM 的突破,在于它用大规模真实数据,给模型先建立了一个 “贴近现实的世界观”。模型不再是从 0 开始学,而是带着对真实世界的理解,再去学具体任务。
结论:这不是一次 “数据竞赛”,而是路线之争
τ0-WM 的发布,不只是刷新了 “最大规模” 的记录,更是在回答一个行业问题:大规模真机数据,到底能不能成为具身智能预训练的核心燃料?
现在看来,答案是肯定的。它给行业指明了一条新的路径:把 “昂贵的真机数据” 从微调阶段,提前到预训练阶段,让机器人先懂世界,再学技能。
未来,当更多人用上这套开源模型,我们或许会看到,机器人学习新任务的门槛越来越低,上手越来越快。
你怎么看这种 “用大规模真机数据预训练” 的路线?欢迎留言讨论。
⚠️ 版权声明
本内容已做唯一性标记(文章 ID:1459),受版权保护,未经本站书面授权,禁止任何形式的转载、复制或搬运。侵权必究,本站保留依法维权的权利。
还没有评论,来说两句?