购物车中没有产品。
阿里 Open Code Review 如何解决 AI 代码审查的致命缺陷
github热门推荐 › 阿里 Open Code Review 如何解决 AI 代码审查的致命缺陷 (第 118 章)
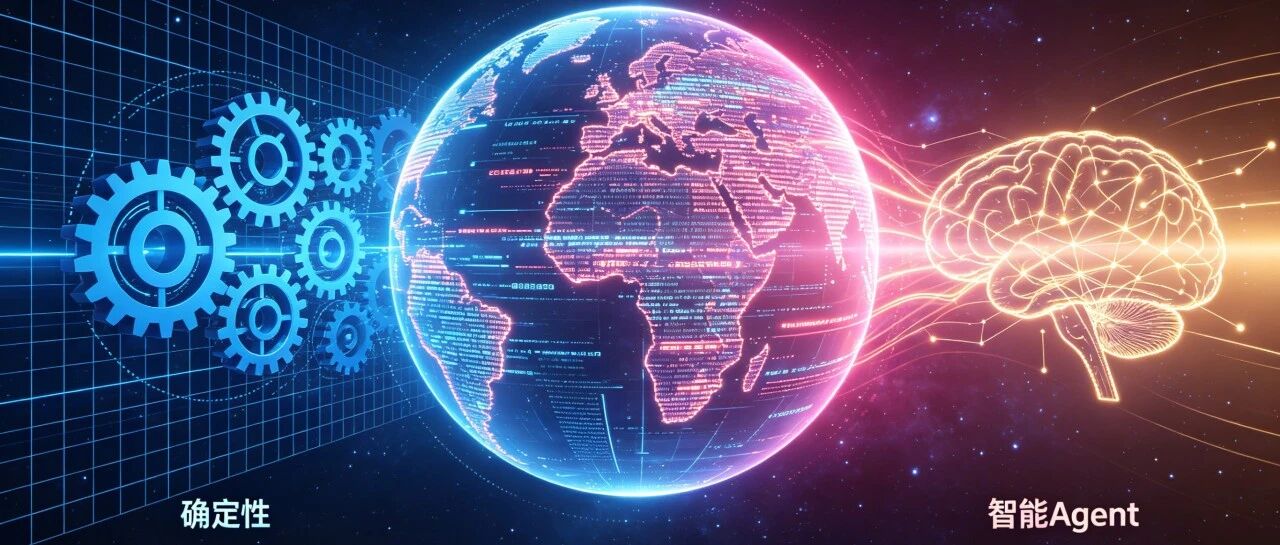
当你还在为 AI 代码审查写 prompt 写到秃头时,阿里已经用一套「确定性工程流水线 + LLM 智能 Agent」的混合架构,把这个问题从 “玄学” 拉回了 “工程化”。
这款在内部打磨两年、服务数万名开发者、识别数百万缺陷的工具,现在开源了。它到底凭什么说自己能解决传统 AI 审查 “漏检、错判、上下文缺失” 的三大痛点?
一、行业的 “皇帝新衣”:AI 代码审查,原来一直在靠 Prompt 撑着?
很长一段时间里,AI 代码审查的主流思路,都是 “把代码丢给大模型,写个好 prompt 让它找问题”。
这种方式看似简单,实则隐患重重:
- 漏检率高
:模型会 “失忆”,对明确的安全漏洞视而不见 - 结果不可复现
:同样的代码,不同时间跑可能得到完全不同的结论 - 上下文缺失
:只能看到提交的 diff,看不到整个项目的关联逻辑
就像让医生只看化验报告的某一行数字,就给病人下诊断,风险可想而知。
阿里的判断很直接:纯 LLM 驱动的代码审查,缺的是硬约束。而 Open Code Review 的解法,就是把问题拆成两半,各司其职。
二、混合架构的底层逻辑:一半 “铁律”,一半 “柔性”
Open Code Review 最核心的创新,就是它的双层架构设计:
1. 外层:确定性工程流水线(Deterministic Pipelines)
这部分是 Go 语言写的 “铁律引擎”,负责解决 “必须不能错” 的问题:
精确选择审查文件,过滤无关变更 按规则匹配已知漏洞(NPE、SQL 注入、线程安全问题等) 做基础静态分析,保证 100% 的可复现性
就像安检机,不管什么人过,违禁品必须被查出来,绝不靠心情。
2. 内层:带工具调用能力的 LLM Agent
这部分才是大模型的主场,但它不是 “裸奔” 的模型,而是被包装成了能主动干活的 Agent:
主动读取项目完整源码,关联上下文 检索同仓库的历史提交和相关代码 从设计合理性、架构优化等开放性角度给出建议
它解决的是规则覆盖不到的 “软性问题”:比如 “这个方法设计是否合理?有没有更好的实现方式?”
两者的配合,相当于先用确定性引擎做 “精准体检”,再让 Agent 做 “深度会诊”,既保证底线,又能挖深问题。
三、为什么这是行业的关键一步?
Open Code Review 的意义,不止于一款工具,而是它戳破了一个行业误区:代码审查不是 prompt 工程问题,而是系统工程问题。
它用确定性规则解决了 AI 审查的 “不可靠性” 问题 用 Agent 的工具调用能力,突破了传统静态分析的 “上下文孤岛” 局限 提供了一套可复现、可扩展的企业级方案,而不是一个依赖模型表现的玩具
对开发者来说,这意味着:✅ 不用再为 prompt 反复调试,规则明确,结果稳定✅ 能同时覆盖已知漏洞和潜在的设计缺陷✅ 支持 Java、TypeScript、Go、Python 等多语言,适配大多数技术栈
四、怎么上手?开源地址在这里
Open Code Review 采用 Apache 2.0 协议开源,项目地址:https://github.com/alibaba/open-code-review
它支持直接作为 CLI 工具使用,也可以集成到 CI/CD 流程中,对接 OpenAI、Anthropic 等多种大模型 API,开箱即用。
结语
当大家都在卷 “谁的 prompt 更牛” 时,阿里的解法是 “给 AI 搭个工程框架”。这或许也预示了 AI 代码工具的下一个阶段:不再比拼模型本身,而是比拼如何用工程化手段,让 AI 的能力变得稳定、可靠、可规模化。
毕竟,对代码审查这种 “差一点都不行” 的场景,比模型聪明更重要的,是模型的判断永远不跑偏。
你怎么看?欢迎留言讨论。
#程序员 #AI 代码审查 #阿里开源 #代码质量 #开发效率
⚠️ 版权声明
本内容已做唯一性标记(文章 ID:562),受版权保护,未经本站书面授权,禁止任何形式的转载、复制或搬运。侵权必究,本站保留依法维权的权利。
还没有评论,来说两句?