-
×
 「英文四线格」A4直接打印・护眼底色・多色可选(近10种样式)
1 × ¥9.90
-
×
 英文单词练字神器 | A4直接打印 | 边背单词边练字,学习效率翻倍!
1 × ¥9.90
购物小计: ¥19.80
加载中
「英文四线格」A4直接打印・护眼底色・多色可选(近10种样式)
1 × ¥9.90 英文单词练字神器 | A4直接打印 | 边背单词边练字,学习效率翻倍!
1 × ¥9.90 购物小计: ¥19.80
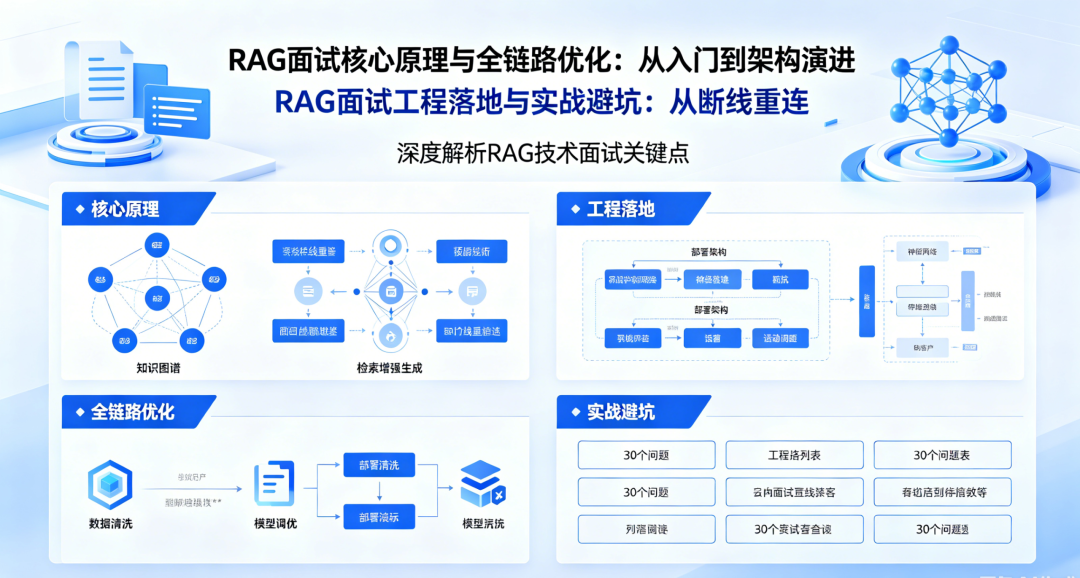
本文聚焦RAG系统的工程化落地、核心技术难点、多模态扩展、失效兜底策略及面试备战技巧,覆盖生产环境中“踩过的坑”和“填过的缝”。适合有RAG项目经验、准备冲击大厂/中厂高级岗位的面试者。
面试官关注你是否真的在生产环境中做过RAG,而非仅仅调过API。
参考答案:
核心思路:用结构锚点和内容指纹定位变更,避免全量重算。
实现方案:
将文档按标题/段落切成块,块边界语义稳定
对每个块计算哈希值,不变则不需要重算Embedding
更新时对比新旧哈希列表,只对变化的块做删除和新增
关键原则:chunk ID要稳定,元数据需能定位到文档/章节/片段。
参考答案:
分层设计:实时推送层 + 可恢复推送层
断线恢复机制:
每条事件分配递增的event_id
事件写入可回放存储(Redis Stream或MySQL)
重连时客户端带上最后收到的event_id
服务端先补发缺失区间,再继续实时推送
关键点:只靠内存不行(多实例会丢),只靠实时推送不行(断线体验差)。
参考答案:
需要分布式锁保证同一会话的唯一执行权。场景包括:
用户刷新/重试导致同一会话重复发起
多端同时连接导致重复推流
断线重连时状态错乱
方案:按session_id做分布式互斥,保证同一时刻只有一个执行者在写流、写状态。
参考答案:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参考答案:
三维监控体系:
日志:记录输入输出和关键中间结果
指标:实时跟踪延迟、错误率、检索召回率
追踪:使用OpenTelemetry实现端到端调用链
关键警示:真正做过生产的工程师会强调“可观测性”,而不仅仅是功能实现。
参考答案:
多级缓存:Redis → 内存缓存 → 磁盘缓存
混合检索:BM25 + 向量检索,兼顾精准匹配与语义泛化
缓存失效策略:基于TTL与内容变化的双因素失效
测试数据显示,合理的缓存策略可使检索延迟降低80%,QPS提升3倍。
这是面试官判断“你是调包侠还是真懂”的分水岭。
错误回答:直接用LangChain的默认文本分割器。
正确方案:
多栏排版:采用布局识别技术,保留多栏原生阅读顺序
表格:保留行列索引,序列化为键值结构化格式
Word:提取标题层级与段落归属,生成树形结构
绑定标准化元数据:文档ID、页码、结构类型
参考答案:
核心方案——父子文档关联切分:
子块(Small Chunk):256 Token左右,负责精准命中
父块(Parent Chunk):1024-2048 Token,保留完整上下文
检索逻辑:先检索子块命中,再返回对应的父块内容
参考答案:
问题本质:RAG对结构化数据的语义理解弱于纯文本
解决方案:混合架构 Text2SQL + RAG
用户查询 → 同时走两条路
路径一:Text2SQL生成SQL,查数据库
路径二:传统RAG检索文档
最终:融合两路结果
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参考答案:
RAG擅长的:单轮知识问答、事实检索
必须用Agent的:
需要多步推理(如“对比A和B产品的优劣势,然后生成采购建议”)
需要调用外部工具(API、计算器、数据库)
需要与环境交互(订票、发邮件)
选型原则:能用RAG解决的问题不要上Agent,Agent的规划不确定性会引入额外风险。
根据最新统计,80%以上的公司会考察RAG/Agent/微调至少两项:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参考答案:
不要孤立回答每个问题,应围绕一个具体项目展开。例如:
“我在做一个AI面试官项目时,遇到多Agent协作的编排问题。我们设计的主控Agent负责节奏,专家Agent负责深挖。具体来说……”
“在文档解析环节,我们遇到PDF多栏排版导致语义断裂的问题,通过布局识别+父子块切分解决……”
参考答案:
用数据说话,面试官非常看重:
“混合检索使召回率从65%提升至82%”
“引入重排序后,P99延迟从500ms降至200ms”
“父子文档切分后,长文档问答准确率从62%升至89%”
参考答案:
工程化思维:讲原理 → 讲场景选择 → 讲工程落地 → 讲可观测与评估
量化指标:每个优化都有前后对比数据
诚实面对边界:知道RAG的局限性比试图包装所有功能更受认可
“RAG的检索依赖知识库质量,数据稀疏时效果不佳”
“多跳推理对Agent来说规划复杂度高,需要人工兜底”
开源贡献/技术博客:有实际影响力证明
第一篇:原理与架构(28个问题)├── 基础认知(3问)├── 全流程拆解(4问)├── 常见问题与优化(4问)├── 检索优化深度(3问)├── 生成优化(3问)├── 评估体系(2问)├── Agent与RAG结合(5问)└── 架构演进与未来(4问)第二篇:工程与实战(15个问题)├── 工程化落地(6问)├── 核心技术难点(3问)├── RAG局限性(2问)└── 面试策略(4问)
按阶段学习:先掌握第一篇的原理,再用第二篇检验工程能力
动手实践:用LlamaIndex或LangChain搭建一个完整的RAG Demo
深度思考:每个优化点背后都有trade-off,理解为什么
量化沉淀:在项目中记录优化前后的对比数据
模拟面试:找人扮演面试官,针对这43个问题进行实战演练
祝面试顺利,拿下心仪的Offer!
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/05/31/rag%e9%9d%a2%e8%af%95rag%e9%9d%a2%e8%af%95%e5%b7%a5%e7%a8%8b%e8%90%bd%e5%9c%b0%e4%b8%8e%e5%ae%9e%e6%88%98%e9%81%bf%e5%9d%91%ef%bc%9a%e4%bb%8e%e6%96%ad%e7%ba%bf%e9%87%8d%e8%bf%9e%e5%88%b0%e5%a4%9a/),并保留原文链接。
还没有评论,来说两句?