告别向量库!98.7% 准确率的 PageIndex,正在颠覆 RAG 底层逻辑
同样一份几百页的上市公司财报,传统向量 RAG 准确率普遍卡在 60%-80% 区间,而 PageIndex 跑出 **98.7%** 的实测成绩(FinanceBench 权威基准)。过去两年被奉为标配的「文档切块 + 向量嵌入 + 向量数据库」三件套,第一次遭遇架构级颠覆。本文拆解:PageIndex 靠什么抛弃向量?它解决了传统 RAG 多年无解的痛点,又会给 AI 知识库落地带来哪些连锁变化?
一、传统 RAG 困局:被切块和向量锁死的天生缺陷
几乎所有做过知识库落地的开发者,都踩过两大无解大坑:
1. 文档切分的两难悖论
为适配 Embedding 模型输入限制,必须把整篇文档硬切成 512~1024token 的碎块:
-
切太小:完整逻辑被拆分,关键数据散落多块,AI 缺上下文频繁 “幻觉”; -
切太大:无关内容混入,噪声挤占上下文,精准度断崖下跌。哪怕动态语义切分、智能分块等优化,只能缓解,无法根治。
2. 向量相似度≠内容相关性
向量检索靠高维空间距离算匹配,天生看不懂逻辑约束:
举例:提问「2024 年公司净利润」,向量常误召回 2023 年财报数据,只因两段文字用词高度相似。它只认 “用词像”,不认 “时间、章节、逻辑从属关系”,这也是金融、法律等专业文档 RAG 落地翻车重灾区。
3. 工程成本层层堆叠
落地一套传统 RAG,要同时维护:分词工具、嵌入模型、向量数据库、分片扩容、索引优化,中小团队运维成本居高不下。
行业数据:传统向量 RAG 在 FinanceBench 金融财报测试平均准确率仅 65%~78%,复杂多章节问题甚至跌破 60%。
二、PageIndex 核心:模仿人类看书,用目录树 + 推理替代向量检索
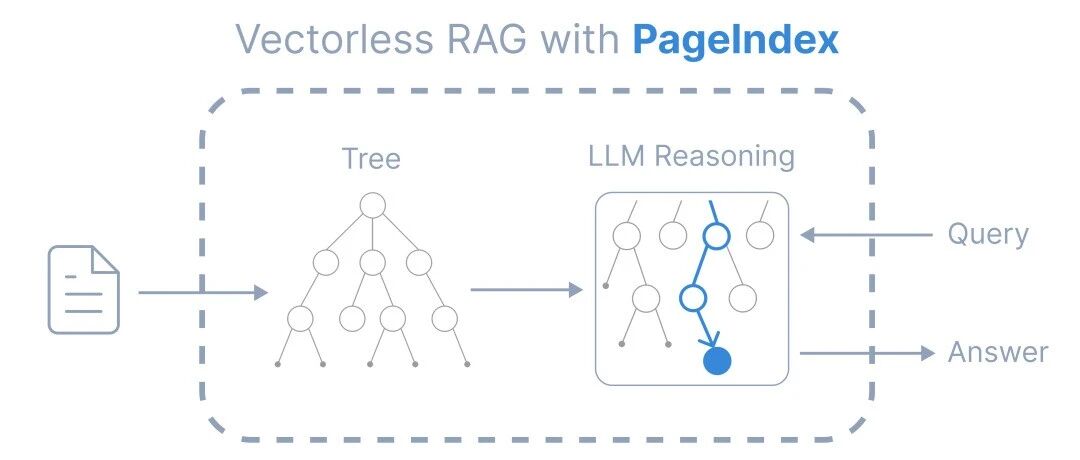
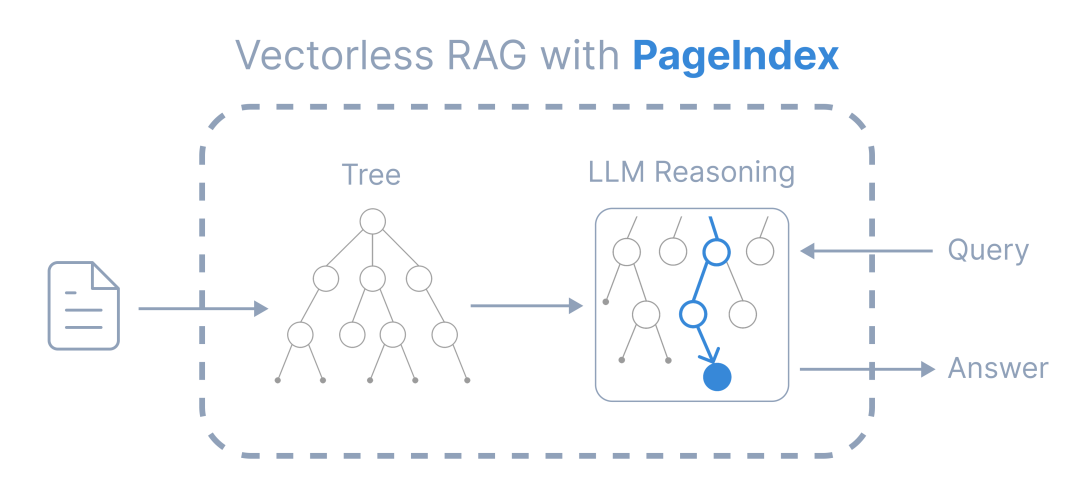
由 Vectify AI 推出的开源框架 PageIndex,核心思路源于人类专家查阅资料的习惯:不靠盲搜关键词,顺着目录逐层翻找章节。
1. 第一步:LLM 生成文档原生树形目录
不粗暴切块,让大模型通读全文,提炼文档天然层级:全书→章节→小节→段落,形成一棵完整结构化目录树,每个节点附带章节内容摘要vectify.ai。
类比:像一本书的目录,保留作者原本的行文逻辑,完整留存上下文从属关系。
2. 第二步:LLM 推理遍历树形索引(核心创新)
用户提问后,大模型化身 “导航员” 逐层决策:
-
先判断根目录下哪些大章节和问题相关; -
进入目标章节,继续筛选下属子小节; -
层层收缩范围,最终定位精准原文段落,一次性提取完整答案。全程没有向量计算、没有相似度比对,完全依靠 LLM 逻辑推理完成检索路径。
三大标志性特性:✅ 无向量:无需 Embedding 模型、彻底移除向量数据库依赖✅ 无切分:遵循文档原生结构,杜绝人为拆分破坏语义✅ 推理驱动:检索过程全链路可追溯,能清晰展示 “AI 从哪一页、哪一节找到答案”
三、实测数据:98.7% 准确率,金融场景实现碾压级领先
在权威金融评测集 FinanceBench(上市公司财报问答基准)中,基于 PageIndex 搭建的 Mafin2.5 系统拿到98.7% 准确率,刷新该榜单纪录。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
数据来源:Vectify AI 官方 FinanceBench 公开测试报告
优势集中在长文档场景:财报、合同、专利、学术手册这类动辄上百页的资料,传统 RAG 越长篇越拉胯,PageIndex 反而随文档结构化优势持续提升精度。
代价客观存在:单次查询需要多轮 LLM 推理,算力开销是向量检索的 R5~15 倍,短文本闲聊知识库不占优势,但专业知识库落地性价比极高。
四、利弊辩证:它不是全盘淘汰向量 RAG,而是场景分流
✅ PageIndex 优势场景
-
长文档专业知识库:金融研报、法务合同、行业白皮书、产品手册; -
对答案溯源、可信度要求极高:企业内审、财税问答、医疗文献检索; -
不想维护向量库、精简技术栈的初创团队。
❌ 向量 RAG 仍不可替代
-
海量短文本知识库:百万级短句知识库、商品标题检索、聊天语料库; -
高并发低成本检索:面向 C 端海量 QPS 的轻量化问答系统; -
语义模糊联想检索:灵感类、宽泛话题的内容推荐。
结论:两种 RAG 路线从 “替代关系” 变成 “互补关系”,未来 RAG 选型不再唯向量论,而是按文档长短、业务精度择优。
五、落地实操:开源地址与快速上手
项目完全开源,采用 MIT 开源协议,小白可快速部署测试:
- 主项目仓库(PageIndex 框架)
# 一键安装git clone https://github.com/VectifyAI/PageIndex.gitcd PageIndexpip install -r requirements.txt -
98.7% 准确率金融实例 Mafin2.5 -
:https://github.com/VectifyAI/Mafin2.5-FinanceBench - 在线试用平台
:https://chat.pageindex.ai(上传 PDF 即时体验推理 RAG)
六、行业展望:RAG 进入双路线并行时代
- 中小开发者红利
:不用再选型、部署、调优各类向量数据库(Pinecone/Chroma/Milvus),单一大模型就能搞定专业知识库,技术门槛大幅下降; - 向量数据库赛道分化
:短文本、高并发场景继续稳固基本盘,长文档专业领域份额被推理式 RAG 持续蚕食; - 下一代 RAG 融合方向
:混合架构出现 —— 短片段用向量快速召回,长章节用 PageIndex 推理精读,兼顾成本与精度。
你在落地 RAG 项目时,被向量检索、文档切分踩过哪些坑?更看好向量 RAG 还是推理式 RAG 的长期发展?欢迎留言讨论。
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/06/06/%e5%91%8a%e5%88%ab%e5%90%91%e9%87%8f%e5%ba%93%ef%bc%8198-7-%e5%87%86%e7%a1%ae%e7%8e%87%e7%9a%84-pageindex%ef%bc%8c%e6%ad%a3%e5%9c%a8%e9%a2%a0%e8%a6%86-rag-%e5%ba%95%e5%b1%82%e9%80%bb%e8%be%91/),并保留原文链接。
还没有评论,来说两句?