1M 上下文提速 9.36 倍!阿里 RTPTurboV2 拆解大模型注意力底层革命
当 Agent、百万字文档解读成为刚需,传统 GPT 标配的 Full Attention 早已沦为性能累赘。序列长度每翻 10 倍,算力与显存消耗就要暴涨 100 倍,要么改用有损压缩的 Linear Attention,要么换高开销的 Sparse Attention,行业陷入二选一困局。
阿里最新发布的 RTPTurboV2 给出全新解法:不用改造 Transformer 底层结构,仅靠百步微调就能释放模型原生稀疏性,最高实现 32 倍注意力计算压缩,在 1 百万 token 超长上下文下推理速度提升 9.36 倍。本文一次性讲透三条技术路线的优劣,看懂这场 Transformer 底层变革会如何重塑大模型落地成本。
一、为什么说 Full Attention 正在被行业抛弃?
1.1 O (N²) 复杂度是天生绝症
传统完整注意力(Full Attention)的计算逻辑很直白:文本里每一个字,都要和全文所有字做关联匹配。
-
1K token 短文:仅需 100 万次运算; -
100K 长文档:运算量直接暴涨至 100 亿次; -
百万级上下文 Agent 任务:单轮推理显存直接爆仓,单条请求成本翻百倍。
举个现实场景:法律 AI 比对整本卷宗、代码 Agent 读取十万行工程代码,只要用原生 Full Attention,单张高端 GPU 都扛不住延迟,商业化落地根本不现实。
1.2 行业两条主流替代路线,各有硬伤
当下厂商普遍分两大阵营,没有完美方案:
路线 A:Linear 线性注意力(Qwen-Next、Kimi-K2)
核心逻辑:直接删掉 softmax,调换矩阵计算顺序,把复杂度压到 O (N),存储开销固定 O (1)。优点:极致省显存,超长文本推理成本最低;短板:强行压缩全局信息,长距离关联精度明显受损,复杂推理任务容易逻辑断层。
路线 B:Sparse 稀疏注意力(DeepSeek-V4 DSA)
核心逻辑:不改动 softmax,只筛选少量关键 token 做计算,稀疏度可达 90% 以上。优点:保留原生注意力逻辑,模型能力几乎无损;短板:需要定制路由模块,训练与推理改造成本高,中小厂商很难复用现有模型底座。
简单一张表看懂三者核心差异:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
二、阿里 RTPTurboV2:不走重构老路,挖掘模型天生稀疏性
2.1 核心颠覆性思路:稀疏是模型自带属性,不用硬加模块
市面上稀疏方案普遍是 “外部强行筛选 token”,而阿里 RTP 团队提出全新认知:大模型预训练完成后,注意力头本身就存在大量冗余,绝大多数头只关注局部文字,只有少数头需要全局长距离关联。我们不需要改造网络,只需要释放它本身的稀疏潜力。
2.2 三大核心技术,百步训练完成 10 倍稀疏压缩
- Headwise 分层筛选
区分全局注意力头与局部注意力头,仅为少量关键头保留完整全局计算,其余头部直接过滤远距离无关 token,从源头砍掉 80% 无效运算。 - 低秩投影压缩
对保留的全局注意力矩阵做轻量化低秩分解,在不丢失语义信息前提下,进一步压缩计算规模。 - 轻量化聚类微调
仅需百步少量微调,就能稳定激活模型内在稀疏特征,全程不改动 Transformer 基础结构,现有 Qwen 系列模型可直接兼容,无需重新预训练。
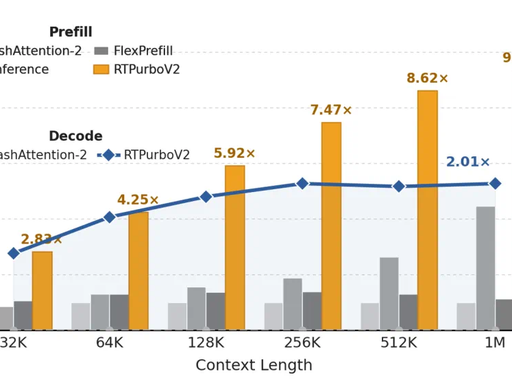
2.3 实测数据:1M 上下文提速 9.36 倍,精度几乎持平
根据机器之心披露的官方测试数据:
-
预填充(Prefill)阶段:32K~1M 上下文实现 2.83x ~ 9.36x 加速; -
解码(Decode)阶段:最高 5.92 倍推理提速; -
精度衰减控制在 0.5% 以内,远超同类稀疏优化方案; -
非侵入式适配:无需修改模型权重架构,魔搭社区所有开源 Qwen 模型一键接入。
三、三条技术路线终极对比:谁会成为行业主流?
3.1 Linear 注意力:适合极致低成本,牺牲推理能力
Kimi、通义千问 Next 选用这条路线,优势是推理硬件门槛最低。但在复杂 Agent 任务、数学推理、多轮长对话中,会出现上下文遗忘、逻辑断裂,更适合内容总结、知识库检索这类简单任务。
3.2 DeepSeek 式原生稀疏:自研大厂专属,中小玩家难复制
DeepSeek-V4 的 DSA 稀疏注意力需要从预训练阶段就嵌入路由筛选模块,模型、推理框架、硬件算子全链路定制优化,研发成本极高,只有头部自研模型团队能落地。
3.3 阿里 RTPTurboV2:通用性最优的折中方案
它完美规避前两者短板:
-
不重构模型,存量开源 / 商用大模型均可快速优化; -
保留完整 softmax 注意力逻辑,复杂任务精度几乎无损; -
少量微调即可生效,训练算力成本极低,兼顾研发与落地性价比。
从产业视角判断:未来会形成分层格局
-
极简长文本服务:Linear 注意力占优; -
自研超大基座模型:原生 Sparse 注意力持续迭代; -
绝大多数通用商用大模型、开源模型:RTPTurboV2 这类轻量化稀疏优化会成为标配。
四、行业趋势升华:Transformer 没有被淘汰,只是进化了
很多人产生一个误区:Full Attention 算力爆炸 = Transformer 架构过时。但从阿里、DeepSeek、通义千问的技术路线能清晰看到:行业并非抛弃 Transformer,而是在优化注意力计算的 “冗余浪费”。
-
Agent 爆发倒逼长上下文技术迭代,算力成本成为商业化核心门槛; -
完全重构模型的路线成本太高,存量模型轻量化稀疏优化是短期最优解; -
底层优化会下沉至推理框架标准工具,未来所有大模型出厂自带稀疏加速能力。
长远来看,不会出现单一技术通吃市场,而是根据场景混合搭配:比如用 RTPTurboV2 做基础加速,搭配滑动窗口注意力处理超长对话,兼顾速度与效果。
阿里这套不用重构模型的稀疏优化方案,会不会成为中小 AI 厂商的降本神器?Linear 和稀疏两条路线你更看好哪一个?欢迎留言讨论。
#阿里 RTPTurboV2 #大模型注意力机制 #Transformer 技术 #长文本大模型 #AI 算力降本 #大模型技术科普
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/06/15/1m-%e4%b8%8a%e4%b8%8b%e6%96%87%e6%8f%90%e9%80%9f-9-36-%e5%80%8d%ef%bc%81%e9%98%bf%e9%87%8c-rtpturbov2-%e6%8b%86%e8%a7%a3%e5%a4%a7%e6%a8%a1%e5%9e%8b%e6%b3%a8%e6%84%8f%e5%8a%9b%e5%ba%95%e5%b1%82/),并保留原文链接。
还没有评论,来说两句?