2026 爬虫新王 Scrapling:10 倍于 Selenium 速度,比 BeautifulSoup 更好用
做爬虫的开发者永远逃不开一道选择题:想要高速并发,选 Requests+BeautifulSoup,却拿不下 JS 动态渲染页面;能模拟浏览器、攻克反爬,用 Selenium,又要忍受龟速加载、高额内存占用。
两套方案来回切换、写两套解析逻辑、网站一改版就要重写选择器 —— 这是过去 5 年爬虫从业者的共同痛点。2026 年全新开源框架 Scrapling 的出现,直接推翻了这个行业固有矛盾:同场景速度是 Selenium 的 10 倍,上手难度低于 BeautifulSoup,还自带网页自适应修复、反爬绕过能力。
一、行业旧困局:爬虫长期陷入「二元取舍」
在 Scrapling 诞生前,主流工具各有致命短板,不存在完美通吃方案:
1. BeautifulSoup(静态解析首选)
-
优点:API 极简、新手友好,解析静态 HTML 零门槛 -
硬伤:无法处理 JS 渲染页面,大规模抓取性能孱弱,网站改版后选择器直接失效
2. Selenium(动态页面刚需)
-
优点:完整浏览器环境,模拟真人操作,绕过大部分基础反爬 -
硬伤:启动浏览器进程开销巨大,抓取千页数据动辄几十分钟,CPU、内存占用翻倍,并发多开极易崩溃
3. Scrapy(大规模爬虫)
-
优点:原生异步并发,适合海量站点爬取 -
硬伤:学习曲线陡峭,不支持动态页面,需要额外搭配 Playwright,代码架构复杂
简单说:快的不能抓动态,能抓动态的跑不快,简单的无法大规模扩展。开发者被迫维护多套技术栈,开发、运维成本居高不下。
二、Scrapling 核心革命:一站式解决速度 + 易用两大痛点
2.1 性能实测:全方位碾压传统工具
官方基准测试与第三方实测数据统一印证,Scrapling 在全场景性能断层领先:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
核心原理:
-
混合抓取架构:内置 Fetcher静态请求、DynamicFetcher无头浏览器、StealthyFetcher隐身反爬三套抓取器,共用同一套高性能解析内核,不用切换库; -
懒加载 + 轻量化 DOM:优化数据结构,不加载无用页面资源,大幅降低硬件开销; -
自研高速序列化引擎,JSON 解析速度是 Python 标准库 10 倍。
2.2 易用性超越 BeautifulSoup,新手零门槛
很多高性能框架会牺牲简洁性,但 Scrapling 反其道而行:
-
统一极简 API,静态 / 动态页面使用完全相同的提取语法; -
内置交互式抓取 Shell,写代码时实时预览页面元素,不用反复运行调试; -
完整类型提示,IDE 自动补全,降低排错成本; -
最亮眼的自适应元素定位:
# 传统BS4,网站改class就失效soup.find("div", class_="goods-name")# Scrapling自动语义匹配,页面改版也能抓到商品名page.find("商品名称", auto_adapt=True)
依托 DOM 相似性算法,即使前端修改标签、class、层级,框架能自动推断目标元素,爬虫维护工作量直接减少 70%,中小团队不用专人维护选择器。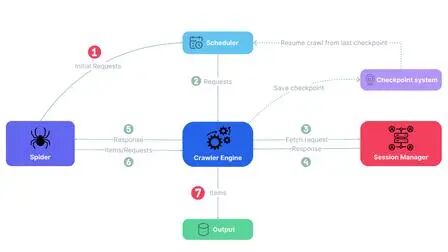
2.3 隐藏王牌:开箱即用的反爬突破能力
市面上多数框架只负责抓取,绕过 Cloudflare、验证码、指纹检测需要额外集成工具,Scrapling 原生内置隐身能力:
-
StealthyFetcher 自动伪造浏览器指纹、请求头、鼠标滑动轨迹; -
原生支持绕过 Cloudflare Turnstile 人机验证; -
多会话、代理池自动轮换、请求节流、失败重试一站式封装。
不用再搭配 undetected-chromedriver、代理管理脚本,一行代码就能构建高隐匿爬虫。
三、落地场景:哪些开发者最适合切换 Scrapling?
1. 个人 / 新手爬虫开发者
不想学习多套库,一套代码搞定静态页面、动态渲染、小规模数据采集,学习成本远低于 Scrapy。
2. 数据采集中小团队
需维护数十个站点爬虫,频繁遇到网站改版,自适应功能大幅降低迭代维护工时。
3. AI 训练数据工程师
需要批量抓取海量网页文本、图片,低内存、高并发特性可以节约服务器算力成本。
4. 电商 / 舆情监控从业者
频繁对抗平台反爬机制,内置隐身抓取无需额外开发反爬模块。
四、快速上手:开源地址与极简示例
官方开源地址
-
GitHub:https://github.com/ScraplingDev/scrapling -
官方文档:https://scrapling.readthedocs.io -
PyPI 安装命令:
pip install scrapling极简抓取示例(动态页面自动渲染)
from scrapling import DynamicFetcher# 初始化浏览器抓取器fetcher = DynamicFetcher()page = fetcher.fetch("https://需要JS渲染的页面.com")# 自适应提取标题,页面改版不失效title = page.find("页面标题", auto_adapt=True).textprint(title)
五、行业趋势总结:爬虫框架进入「智能自适应时代」
过去十年爬虫工具迭代逻辑:静态解析库 → 浏览器模拟工具 → 分布式爬虫框架但始终没有解决「多工具割裂、维护成本高、性能损耗大」三大核心问题。
Scrapling 的出现代表下一代抓取工具的发展方向:
- 一体化
:静态、动态、反爬、分布式能力收拢到单一框架; - 智能化
:AI 语义辅助解析,自动适配网页变化,减少人工维护; - 轻量化
:摒弃重型浏览器冗余开销,兼顾速度与浏览器能力。
短期来看,存量 Selenium、BeautifulSoup 项目不会立刻淘汰,但新爬虫项目优先选择 Scrapling 会成为行业共识;长期,自带自适应修复、低资源消耗的智能抓取框架,会逐步替代传统割裂式工具栈。
你平时写爬虫更头疼页面改版,还是 Selenium 速度太慢?有没有试过一套工具兼顾静态与动态抓取?欢迎留言讨论。
#Python 爬虫 #Scrapling #数据抓取 #程序员工具 #爬虫框架推荐 #大数据采集
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/07/03/2026-%e7%88%ac%e8%99%ab%e6%96%b0%e7%8e%8b-scrapling%ef%bc%9a10-%e5%80%8d%e4%ba%8e-selenium-%e9%80%9f%e5%ba%a6%ef%bc%8c%e6%af%94-beautifulsoup-%e6%9b%b4%e5%a5%bd%e7%94%a8/),并保留原文链接。
还没有评论,来说两句?