MIT MeMo 论文:独立记忆小模型,颠覆 RAG 外挂知识库方案
前言:当下企业知识库方案三大死局
所有落地 LLM 知识库的开发者,长期被困在三条技术路线里,各自存在无法根治的短板:
- RAG 检索增强(当前主流)
依赖向量数据库、文本分块、相似度匹配。致命缺陷:极易受到检索噪声干扰;跨文档、多跳推理能力薄弱;检索不到正确片段就直接答错;需要维护整套索引、切片、重排工程链路。 - 微调 / 持续预训练
把知识灌入大模型权重。成本极高,训练算力消耗巨大;极易产生灾难性遗忘;知识库更新就要重新微调,无法频繁迭代业务文档。 - 隐式记忆(Latent Memory、软 Token 压缩)
将知识压缩为模型专属隐向量。记忆表示和基座模型强绑定,一套记忆无法迁移到其他 LLM;不支持闭源黑盒大模型(GPT、Gemini 等)。
行业一直在寻找第四条路线,而 MIT MeMo 正式给出全新范式:不再用数据库存放知识,而是训练一个专职 “记忆小模型”。
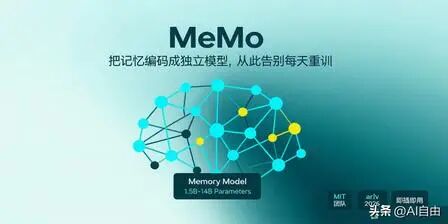
MeMo核心概念海报
一、MeMo 核心架构:两大模型彻底分工
MeMo 架构拆分为两个完全独立、互不干扰的模型,推理主模型全程冻结,永不微调:
1. Executive Model(执行模型|推理大脑)
就是我们日常使用的大模型(Qwen、Llama、Gemini 等,闭源 API 模型同样兼容)。职责:理解用户提问、拆解复杂问题、多轮询问记忆模型、汇总信息、输出最终答案。✅ 全程冻结,不需要改动任何权重,不用重新训练。
2. Memory Model(记忆模型|独立知识库)
专门训练的轻量化小模型(实验采用 1.5B~14B 参数规模)。职责:内化全部业务语料、文档、事实知识;接收执行模型发出的子问题,返回事实信息。
本质:参数化知识库,替代向量数据库 + 原始文档集合
补充:训练阶段 Generator Model
离线流水线使用,负责把原始文档自动生成Reflection QA 反思问答数据集,用于训练记忆模型。
通俗比喻RAG = 大模型拿着关键词去图书馆翻纸质文件;MeMo = 大模型旁边坐着一位熟读全部资料的专家(记忆小模型),有问题直接向专家提问。
二、完整工作流程:训练阶段 + 推理阶段
阶段 1:离线构建记忆模型(一次性训练)
原始业务文档 → 自动生成反思 QA 数据集 → 训练 Memory Model论文提出Reflection QA 合成流水线,不只是简单问答对:
-
提取文档实体、事实关系 -
跨文档合并信息,生成多跳类问题 -
消除指代歧义,保证问答自完备训练完成后,所有业务知识永久固化在记忆模型权重中,不再需要保存原始文档、向量索引。
阶段 2:在线推理三阶段交互协议(核心创新)
执行模型和记忆模型通过自然语言多轮对话交互,固定三段式流程:
- 广域锚定(Grounding)
执行模型把复杂用户问题拆成多个原子子问题,批量询问记忆模型,宽泛收集候选事实。 - 实体收敛(Entity Identification)
基于初步信息持续追问,不断缩小范围,锁定目标实体,解决模糊查询。 - 答案合成(Answer Seeking)
围绕确定实体调取精准事实,收集充足素材后,由执行模型整合输出最终回答。
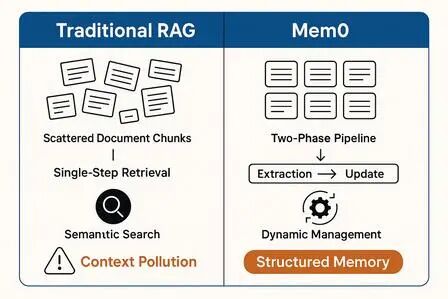
MeMo vs 传统RAG流程对比
三、MeMo VS RAG / 微调 / 隐记忆 全面对比
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| MeMo |
|
|
|
|
|
固定,与语料规模无关 |
MeMo 对比 RAG 的关键优势
- 天然擅长跨文档多跳推理
知识已经在模型内部建立关联,不需要依靠片段相似度拼接信息; - 抗噪声能力极强
不存在检索错误、无关片段污染上下文的经典 RAG 痛点; - 省去整套向量工程
不需要文本切片、Embedding 模型、向量数据库、重排模块; - 记忆模型一次训练,多基座通用
训练好的 Memory Model,可以同时供给 Qwen、Llama、闭源 Gemini 等不同执行模型调用; - 推理开销稳定
知识库文档再多,交互轮次固定,不会出现检索耗时持续上涨。
实测数据:在 MuSiQue、BrowseComp-Plus 多跳问答数据集上,相比标准 RAG 最高提升26.73% 准确率。
四、客观认清:MeMo 当前落地短板(论文明确提及)
技术文章拒绝无脑吹捧,客观梳理局限性:
- 离线训练成本高
大规模语料生成 Reflection QA 数据集需要大量 GPU 算力,前期投入远高于直接搭建 RAG; - 知识增量更新困难
新增业务文档,很难增量更新记忆模型;主流方案只能重新训练,暂时缺少成熟增量蒸馏方案; - 推理存在多轮交互延迟
执行模型与记忆模型多轮问答,相比单轮 RAG,请求次数更多,端到端延迟更高; - 不适合极小知识库场景
几十篇文档以内,直接长上下文或者简易 RAG 性价比更高;MeMo 优势体现在上万篇文档级大规模知识库; - 存在知识容量上限
记忆模型参数固定,当语料体量极大时,会出现知识压缩失真。
五、哪些场景适合尝试 MeMo?哪些场景继续用 RAG?
✅ 优先考虑 MeMo
-
企业稳定知识库、产品手册、行业规范,知识低频更新; -
大量需要跨文档关联、多跳复合查询的问答系统; -
需要同时对接多款开源 + 闭源大模型,知识库统一复用; -
不想维护复杂向量库、持续优化 RAG 检索链路。
✅ 继续选用传统 RAG
-
资讯、实时数据、频繁更新的动态知识库; -
文档数量少、以简单单文档查询为主; -
业务要求极低推理延迟、毫秒级响应; -
预算有限,无法承担前期模型训练算力。
六、行业思考:MeMo 意味着什么?
长久以来,业界默认二分法:知识要么存在外部数据库(非参数,RAG),要么存在模型权重内部(参数,微调)。
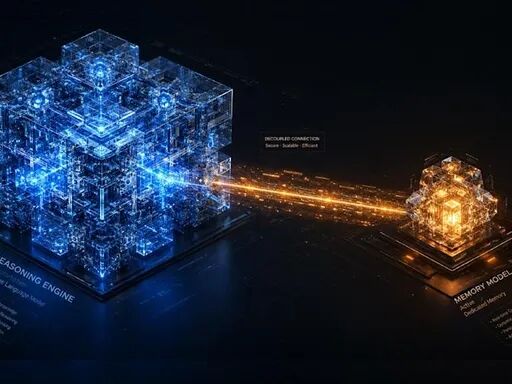
MeMo 开辟了第三条道路:知识独立成一个专用参数模型,实现「推理引擎」与「知识库」硬件、权重、生命周期完全解耦。
它不是彻底淘汰 RAG,而是提供一套全新备选范式。未来很可能出现混合架构:高频变动数据走 RAG,稳定海量领域知识使用 MeMo 记忆模型。
文末一句话总结
MIT MeMo《Memory as a Model》提出独立记忆模型新思路,抛弃向量检索架构,将业务知识库训练成轻量化专用小模型;主推理大模型全程冻结,抗检索噪声、跨文档推理更强,知识可跨 LLM 迁移,是大规模企业知识库替代传统 RAG 极具潜力的新方案。
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/08/13/mit-memo-%e8%ae%ba%e6%96%87%ef%bc%9a%e7%8b%ac%e7%ab%8b%e8%ae%b0%e5%bf%86%e5%b0%8f%e6%a8%a1%e5%9e%8b%ef%bc%8c%e9%a2%a0%e8%a6%86-rag-%e5%a4%96%e6%8c%82%e7%9f%a5%e8%af%86%e5%ba%93%e6%96%b9%e6%a1%88/),并保留原文链接。
还没有评论,来说两句?