购物车中没有产品。
139. 单词拆分(中等)
Blind 75 › 139. 单词拆分(中等) (第 9 章)
题目
给定字符串 s 和一个字符串列表 wordDict 作为字典。若能把 s 完整切成 1 个或多个字典单词,返回 true;否则返回 false。
两个注意点:字典里的单词不要求全部用上;每个单词可以重复使用任意次。
自造示例 1:s = "codebook",wordDict = ["code","book"] → true("code" + "book")。
自造示例 2:s = "codebooks",wordDict = ["code","book"] → false(末尾的 "s" 无法匹配)。
自造示例 3:s = "aaaa",wordDict = ["a","aa"] → true(可 "aa"+"aa",也可重复使用 4 个 "a")。
约束:1 ≤ s.length ≤ 300;1 ≤ wordDict.length ≤ 1000;1 ≤ wordDict[i].length ≤ 20;所有字符均为小写字母;字典单词互不相同。
思路
一句话:设 dp[i] 表示“s 的前 i 个字符能否被完全切成字典单词”,从左到右依次推。
先想最直白的回溯:从位置 start 出发,若某个前缀在字典里,就递归去切剩余部分;只要有一条路能走到末尾就算 true。它的代价是指数级:例如 s = "aaaaa"、字典含 "a" 和 "aa" 时,每个间隔都可“切/不切”,分支接近 O(2^(n-1)),而且同一个后缀会被反复搜索。
关键观察:判断“能不能切完”只需要看每一个前缀终点,不需要记录具体怎么切。若最后一段单词是 s[j:i],那么只要 dp[j] 为真、且 s[j:i] 在字典里,dp[i] 就为真。也就是说:
dp[i] = (dp[j] 为真 且 s[j:i] 在字典中) 对某个 j < i 成立。
这就把“枚举所有切法”压缩成“n+1 个布尔状态”。选定做法:自底向上的一维 DP,再用哈希集合把“查一个词是否在字典里”降到平均 O(词长)。
| 做法 | 时间 | 空间 | 问题 |
|---|---|---|---|
| 回溯 | O(2^(n-1)) | O(n) | 重叠子问题爆炸 |
| 记忆化搜索 | O(n·L²) | O(n) | 可行,但递归常数稍大 |
| 自底向上 DP(本文) | 最好 O(n),平均/最坏 O(n·L²) | O(n+M) | 迭代、无递归 |
解法
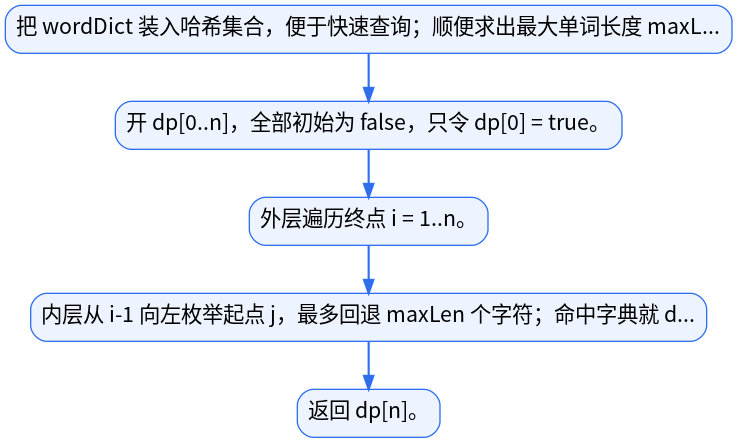
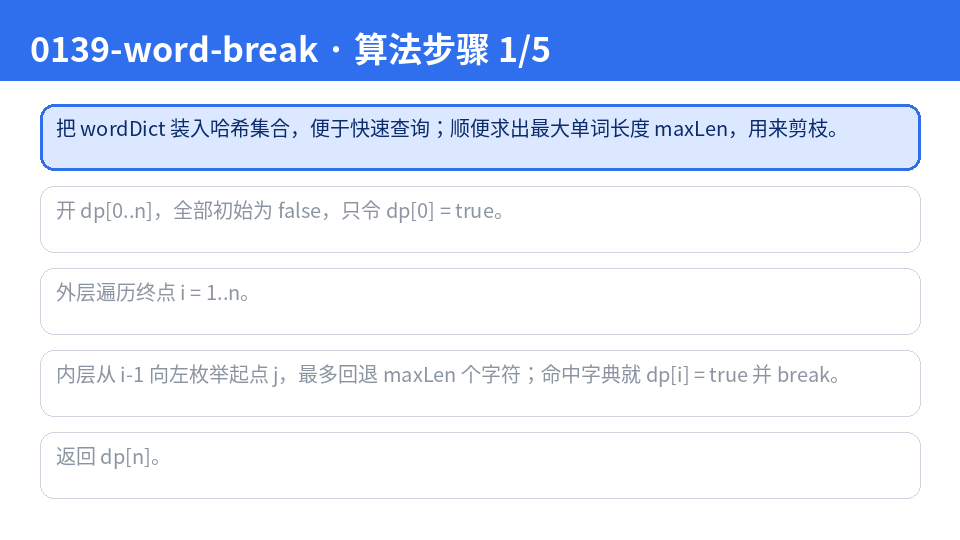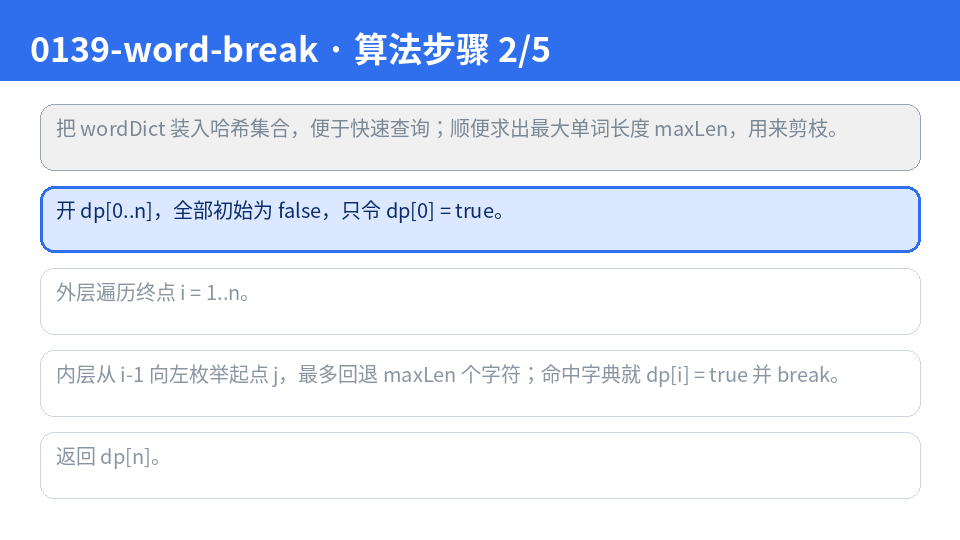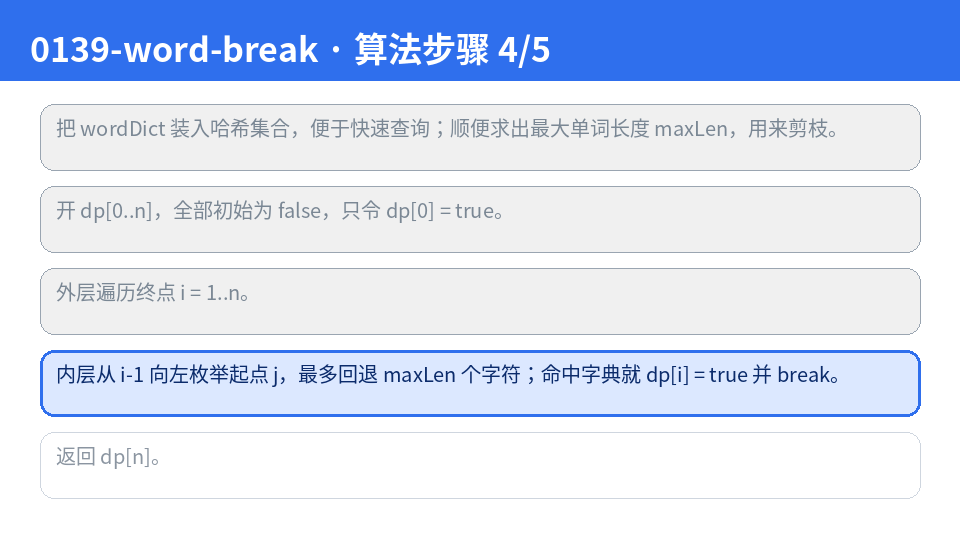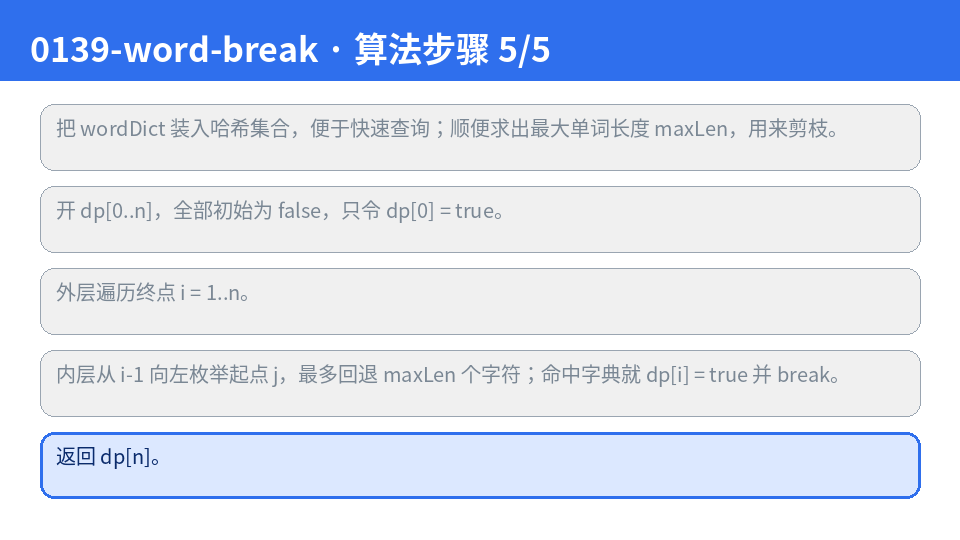
dp[0] = true 表示“空串一定可以切完”。对每个终点 i,枚举最后一段的起点 j:若 dp[j] 为真,且 s[j:i] 在字典中,就把 dp[i] 置真并提前跳出。
- 把
wordDict装入哈希集合,便于快速查询;顺便求出最大单词长度maxLen,用来剪枝。 - 开
dp[0..n],全部初始为false,只令dp[0] = true。 - 外层遍历终点
i = 1..n。 - 内层从
i-1向左枚举起点j,最多回退maxLen个字符;命中字典就dp[i] = true并break。 - 返回
dp[n]。
| i | 尝试的最后一段 | 是否在字典 | dp[i] |
|---|---|---|---|
| 0 | — | — | true |
| 4 | j=0,s[0:4]="code" | 是 | true |
| 8 | j=4,s[4:8]="book" | 是 | true |
表中小例子对应 s = "codebook"、wordDict = ["code","book"]:先由 dp[0] 推出 dp[4],再由 dp[4] 推出 dp[8],最终返回 dp[8]。
下图把上面 5 个步骤串成流程,并逐步演示:
C++
class Solution {
public:
    bool wordBreak(string s, vector<string>& wordDict) {
        unordered_set<string> dict(wordDict.begin(), wordDict.end());

        int maxLen = 0;
        for (const string& w : wordDict) {
            if ((int)w.size() > maxLen) {
                maxLen = (int)w.size();
            }
        }

        int n = (int)s.size();
        vector<bool> dp(n + 1, false);
        dp[0] = true;  // 前 0 个字符:空串视为可切完

        for (int i = 1; i <= n; ++i) {
            int start = i - maxLen;
            if (start < 0) start = 0;

            for (int j = i - 1; j >= start; --j) {
                if (dp[j] && dict.count(s.substr(j, i - j))) {
                    dp[i] = true;
                    break;
                }
            }
        }
        return dp[n];
    }
};
Python
Python 3 示例
最优方案已经在上面第一部分(DP)给出;下面两种仅是等价/变体写法,日常首选 DP。
另一种写法:按词典里的单词逐个匹配
原写法是“枚举最后一段的起点 j”,另一种写法是“从已经能切完的位置向前拼接”:从每个 dp[i] == true 的位置出发,尝试每一个字典单词 w,若 s[i : i + len(w)] == w,就把 dp[i + len(w)] 置真。
它不一定会更快,关键看字典单词个数与最长单词长度的关系:
| 写法 | 最坏时间 | 更快的场景 |
|---|---|---|
枚举起点 j(本文主解法) | O(n·L²) | 字典很大、单词很长时更稳 |
| 按词典单词循环(本小节) | O(n·K·W) | 单词数少、单词短时更划算 |
其中 K 是词条数、W 是平均词长、L 是最长词长。例如字符串很长而字典只有几个短词时,按词典循环明显更快;如果字典里有上千个词,原写法的 L 限制更有利。
class Solution {
public:
bool wordBreak(string s, vector<string>& wordDict) {
unordered_set<string> words(wordDict.begin(), wordDict.end());
int n = (int)s.size();
vector<bool> dp(n + 1, false);本篇为付费内容
您已阅读试读部分,购买后即可解锁全文。
⚠️ 本站内容已做唯一性标记并受版权保护,未经授权禁止转载,侵权必究。
还没有评论,来说两句?