购物车中没有产品。
269. 火星词典(困难)
Blind 75 › 269. 火星词典(困难) (第 48 章)
题目
某个外星文明也使用英文小写字母,但它的字典顺序与人类英语不同。现在给你一本按这种外星字典序排好的单词表,请你还原这些字母之间的先后顺序。
规则是:相邻两个单词若前缀相同,那么第一处不同的字符 x、y 就说明 x 排在 y 前面。把所有这种关系汇总起来,输出一个包含全部出现字符、且满足所有先后关系的排列。
如果这些关系互相矛盾(存在环),或者单词表本身不可能成立(一个更长的单词排在它的前缀前面),就返回空串 ""。
自造示例:["wrt","wrf","er","ett","rftt"] → "wertf"。推导:t 在 f 前、w 在 e 前、r 在 t 前、e 在 r 前,于是可排成 w → e → r → t → f。
自造非法示例:["z","x","z"] 会同时推出 z → x 与 x → z,成环,应返回 "";["abc","ab"] 是前缀冲突,也应返回 ""。
约束:单词数 1 ~ 100;单个单词长度 1 ~ 100;字符均为小写英文字母;答案可以是任意合法顺序。
思路
一句话:把“相邻单词的第一个不同字符”变成一条有向边,答案就是这张图的一个拓扑排序。
先想最直白的做法:把单词两两比较。对任意两个词找第一个不同字符,确实能挖出一些先后关系。但单词表已经有序,利用传递性,相邻单词已经携带了全部必要信息;非相邻词之间的差异,都能由相邻差异一路“传递”出来。两两比较不只是 O(n²·L),还会加进大量冗余边。
更关键的是:就算把先后关系全找齐,我们面对的也不是普通排序,而是偏序关系。例如只知道 a → c、b → c,并不能确定 a、b 谁先谁后,它们可以任意排列。把这种“只知道一部分先后”的关系展开成一行,正是拓扑排序要做的事。
于是做法分成三步:
- 收集节点:所有出现过的字符都要进入答案,即使它没参与任何比较。
- 相邻比较建边:逐对相邻单词找第一处不同字符
x, y,加边x → y。 - 拓扑排序:不断取出“前面已经没有字母”的字符;若最终无法输出全部字符,说明存在环。
另一个关键观察:前缀冲突本身就是非法输入。若 w1 比 w2 长,且 w2 是 w1 的前缀,按字典规则较短者必须排在前面,所以 ["abc","ab"] 不可能成立,直接返回空串。
解法
主解法是拓扑排序。下面 C++ 用 Kahn(入度 BFS),Python 用三色 DFS;两段代码实现的是同一个算法,只是拓扑排序的写法不同,任选其一即可。
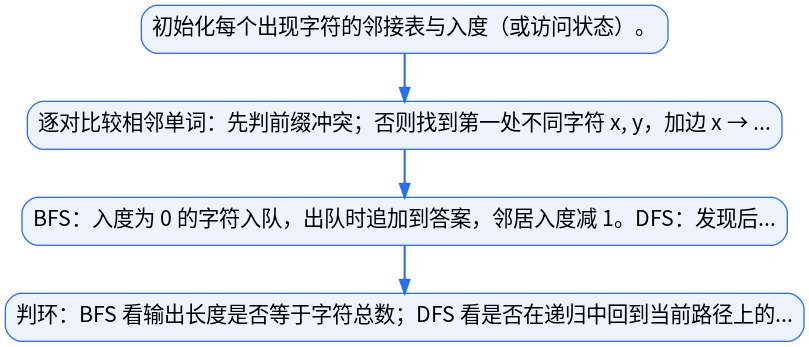
- 初始化每个出现字符的邻接表与入度(或访问状态)。
- 逐对比较相邻单词:先判前缀冲突;否则找到第一处不同字符
x, y,加边x → y,随即跳出当前单词对。 - BFS:入度为 0 的字符入队,出队时追加到答案,邻居入度减 1。DFS:发现后向边即判环,后序记录后再整体反转。
- 判环:BFS 看输出长度是否等于字符总数;DFS 看是否在递归中回到当前路径上的点。
| 相邻单词 | 第一个不同字符 | 得到的有向边 | 含义 |
|---|---|---|---|
| wrt, wrf | t, f | t → f | t 在 f 前 |
| wrf, er | w, e | w → e | w 在 e 前 |
| er, ett | r, t | r → t | r 在 t 前 |
| ett, rftt | e, r | e → r | e 在 r 前 |
把这些边连起来就是一条链 w → e → r → t → f,输出其中任意合法拓扑序均可,例如 "wertf"。
下图把上面 4 个步骤串成流程,并逐步演示:
C++
#include <map>
#include <queue>
#include <string>
#include <unordered_set>
#include <vector>
using namespace std; class Solution {
public:
string alienOrder(vector<string>&本篇为付费内容
您已阅读试读部分,购买后即可解锁全文。
⚠️ 本站内容已做唯一性标记并受版权保护,未经授权禁止转载,侵权必究。
还没有评论,来说两句?