购物车中没有产品。
242. 有效的字母异位词(简单)
Blind 75 › 242. 有效的字母异位词(简单) (第 2 章)
题目
给定两个字符串 s 和 t,判断 t 是不是 s 的字母异位词。
所谓字母异位词:两个串的长度相同,并且每个字母出现的次数也完全相同,只是字母排列顺序可以不同。
自造示例:s = "listen",t = "silent" → true;s = "bottle",t = "battle" → false。
约束:字符串长度 1 ~ 5 × 10⁴;字符仅小写字母。
进阶:如果字符串里可能出现 Unicode 字符(中文、emoji 等),你的解法要如何调整?
思路
一句话:异位词的顺序可以随便换,唯一不变的是每个字母的出现次数,所以数一数、比一比即可。
最直白的做法:把 s 和 t 各自排序,再看两个结果是否相等。比如 "listen" 与 "silent" 排完都是 "eilnst"。这个思路完全正确,也很好写,但排序要花 O(n log n) 的时间——当长度到 5 × 10⁴ 时,其实没必要花这个排序的代价。
关键观察:题目明确只有 26 个小写字母。两个串是不是异位词,等价于“26 个字母中,每一个在两边出现的次数是否都相等”。于是问题变成一次线性扫描:
- 先看长度,长度不同直接
false; - 用一张 26 格的计数表,扫
s时加一、扫t时减一; - 如果最后所有格子都回到 0,说明两边每个字母的次数完全一致。
这样一趟就能判断,时间是 O(n);计数表固定 26 格,额外空间是 O(1)。
解法
用「同一个计数数组 + 一加一减」最省事:s 里的字符让计数 +1,t 里的字符让计数 -1。如果两个串是异位词,最终所有计数必然清零;只要有一个格子不是 0,就说明某个字母数量不匹配。
| 步骤 | 操作 | 说明 |
|---|---|---|
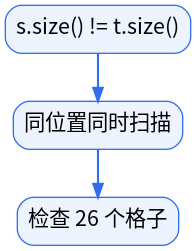
| 1 | s.size() != t.size() | 长度不同,不可能同构,直接返回 false |
| 2 | 同位置同时扫描 | cnt[s[i]] += 1,cnt[t[i]] -= 1 |
| 3 | 检查 26 个格子 | 全为 0 才是异位词 |
以 s = "anagram"、t = "nagaram" 为例:a 各出现 3 次、n、g、r、m 各出现 1 次,一加一减后全部清零,返回 true。
下图把上面 3 个步骤串成流程,并逐步演示:
C++
class Solution {
public:
    bool isAnagram(string s, string t) {
        if (s.size() != t.size()) return false;   // 长度不同必不成立

        int cnt[26] = {0};
        for (int i = 0; i < (int)s.size(); ++i) {
            ++cnt[s[i] - 'a'];                     // s 的字符加一
            --cnt[t[i] - 'a'];                     // t 的字符减一
        }

        for (int i = 0; i < 26; ++i) {
            if (cnt[i] != 0) return false;         // 有字母数量不匹配
        }
        return true;
    }
};
Python
Python 3 示例
还没有评论,来说两句?