购物车中没有产品。
49. 字母异位词分组(中等)
Blind 75 › 49. 字母异位词分组(中等) (第 4 章)
题目
给定一个只含小写字母的单词列表,把“由同一组字母、任意换序得到”的单词归到同一组,输出所有分组(组内、组间顺序不限)。
换句话说:两个词只要每个字母出现的次数都相同,就属于同一组(这层关系叫字母异位词)。
自造示例:["ab","ba","abc","cab","bca","zz"] → [["ab","ba"],["abc","cab","bca"],["zz"]]
约束:单词数 1 ~ 104;单个单词长度 0 ~ 100;字符仅小写字母。
思路
一句话:给每个字符串算一个“指纹”,指纹相同的就归为一组。
先想最笨的:两两比较是不是异位词。这要 O(n²) 次比较;更糟的是同一组里的 k 个串会互相比较 O(k²) 次,全是重复劳动。
关键观察:字母异位词是一种等价关系(自反、对称、传递),所以根本不用两两比——只要给每个串算出一个“规范指纹”,指纹相同就必然同类。
指纹怎么取?两种都行:
- 排序:把字符排序,
"ba" → "ab"。异位词排完必然一样,代价 O(l log l)。 - 计数:数每个字母出现几次,
"ba" → a1 b1。异位词计数必然一样,代价 O(l)。
题目只有小写字母(26 个),计数更快,选它。
解法
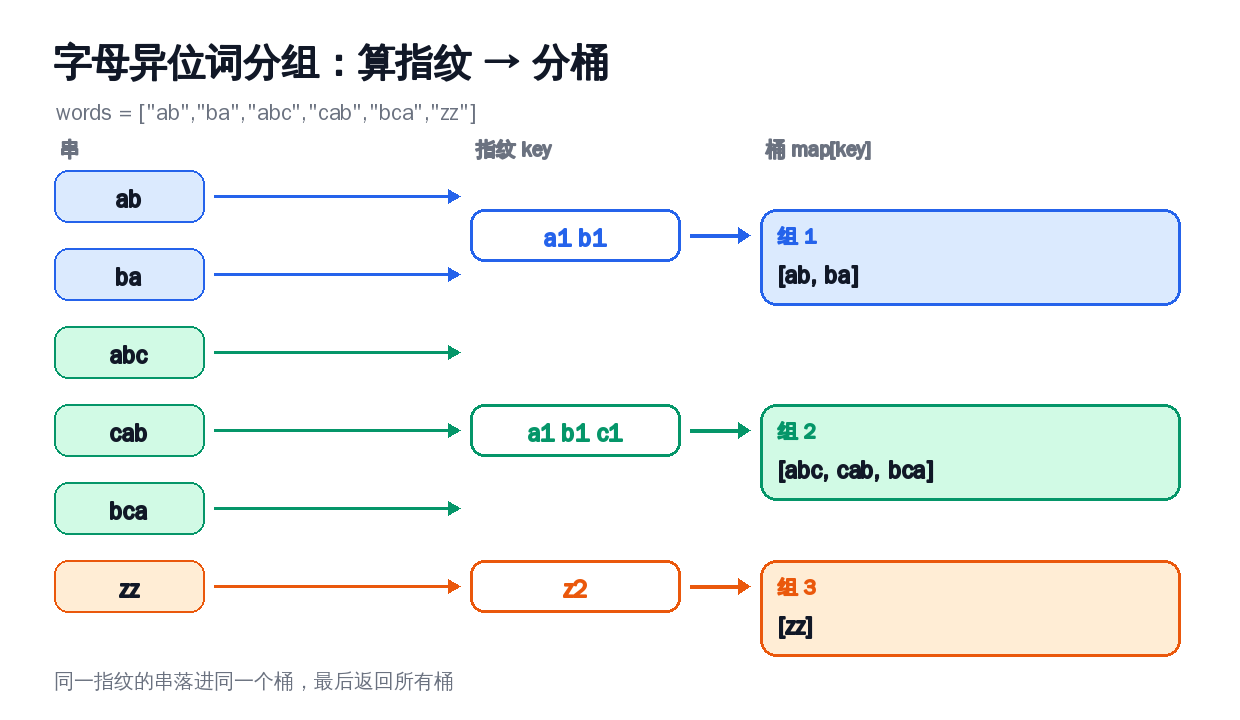
用哈希表 map[指纹] = 同组字符串列表,遍历一遍即可:
- 对每个串
s,数出 26 个字母的出现次数,拼成指纹key。 - 把
s追加到map[key]。 - 返回
map的所有 value。
| 串 | 指纹 key | 桶 map[key] |
|---|---|---|
| ab | a1 b1 | [ab] |
| ba | a1 b1 | [ab, ba] |
| abc | a1 b1 c1 | [abc] |
| cab | a1 b1 c1 | [abc, cab] |
| bca | a1 b1 c1 | [abc, cab, bca] |
| zz | z2 | [zz] |
同一指纹的串自然落进同一个桶,最后返回所有桶即可。
C++
class Solution {
public:
vector<vector<string>> groupAnagrams(vector<string>& strs) {
unordered_map<string, vector<string>> groups;
for (const string& s : strs) {
groups[makeKey(s)].push_back(s);
} vector<vector<string>> ans;
ans.reserve(groups.size());
for (auto& kv : groups) {
ans.push_back(kv.second); // 题目允许任意顺序,无需排序
}
return ans;
} private:
// 固定顺序拼计数 + '#' 分隔:既与顺序无关,又无歧义
string makeKey(const string& s) const {
int count[26] = {0};
for (char c : s) {
++count[c - 'a'];
}
string key;
key.reserve(26 * 3);
for (int i = 0; i < 26; ++i) {
key += to_string(count本篇为付费内容
您已阅读试读部分,购买后即可解锁全文。
⚠️ 本站内容已做唯一性标记并受版权保护,未经授权禁止转载,侵权必究。
还没有评论,来说两句?