购物车中没有产品。
千亿级分布式索引构建技术咨询|10x 提速 · 滚动建库 · 低改造成本
¥9.90
面向搜索、推荐、广告、向量检索等场景,提供基于 Hadoop MapReduce 的千亿级分布式索引构建咨询:架构设计、可靠性保障、滚动建库、低改造成本接入与性能优化。
描述
千亿级数据,索引构建不该成为业务上线和迭代的瓶颈。
面向搜索、推荐、广告、向量检索、企业知识库等场景,提供基于 Hadoop MapReduce 的千亿级分布式索引构建咨询。覆盖架构设计、任务拆分、可靠性保障、滚动建库、低成本接入与性能优化。
不只讲“分布式”概念,而是围绕你的数据规模、索引类型、集群资源和上线节奏,给出可执行的架构、参数、接入清单和灰度切换路径。
你可能正在经历
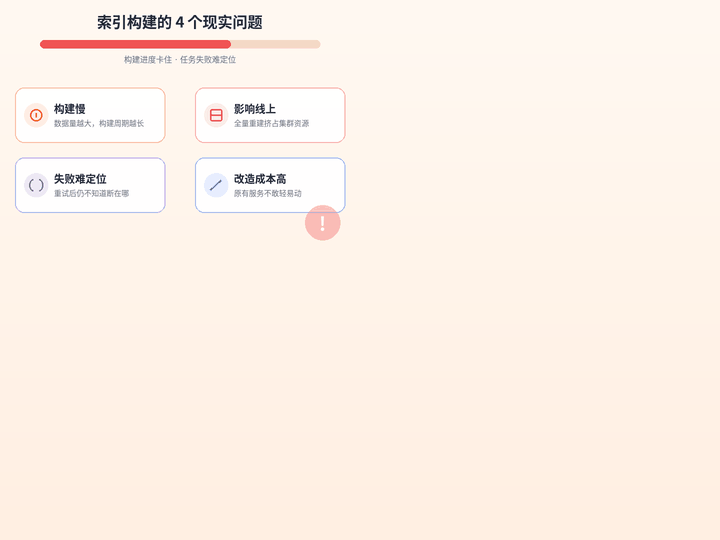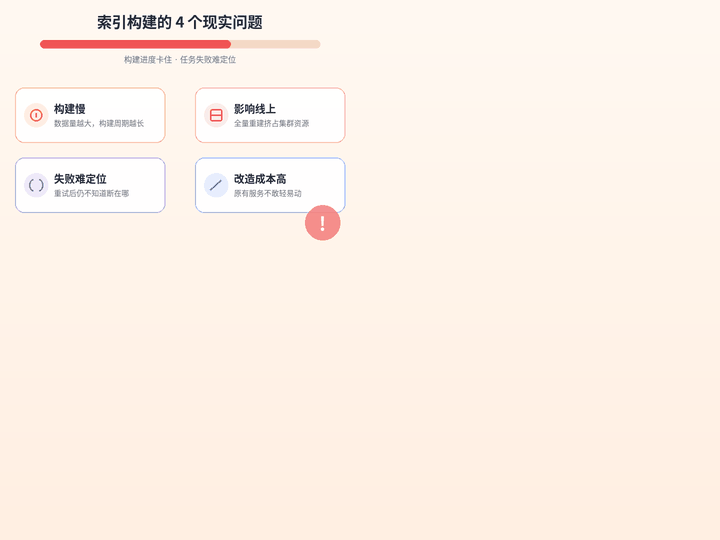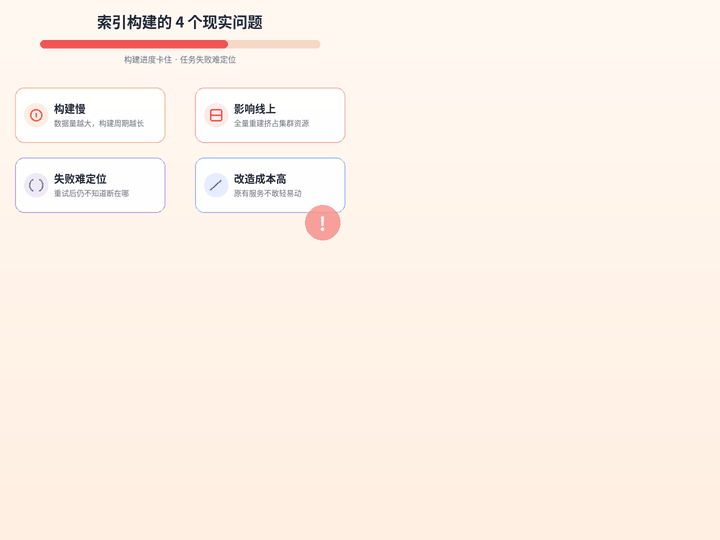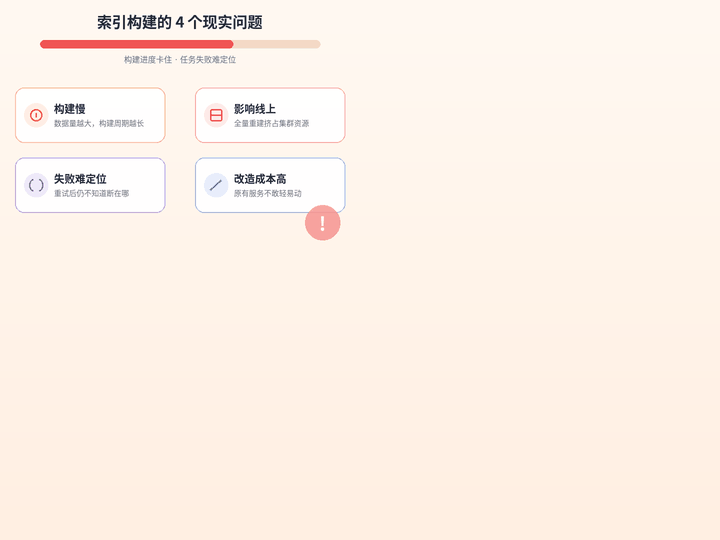
- 数据量达到千亿级,索引构建慢、周期长,业务等不起;
- 全量重建挤占集群资源,影响线上查询稳定性;
- 任务失败后难以定位,缺少断点续建,只能从头再来;
- 向量索引、文本索引分散建设,维护成本越来越高;
- 原有服务改造重、上线风险大,不敢轻易动架构;
- 想扩索引类型、缩短数据新鲜度,却缺少可复用的构建平台。
方案总览:一套平台,打通数据到索引
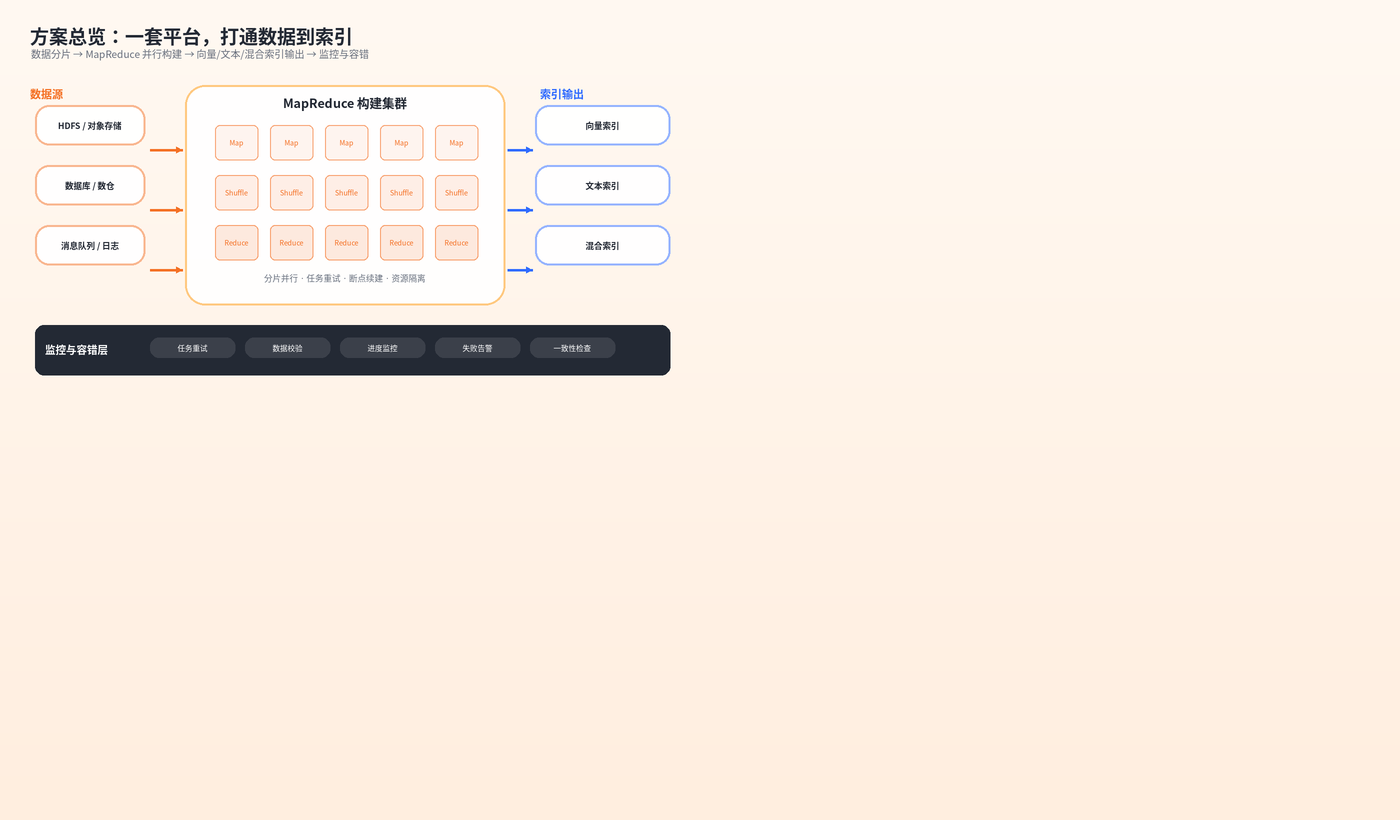
平台把“数据接入、分片、并行构建、索引输出、监控容错”串成一条完整链路:左侧接现有数据源,中间用 MapReduce 集群并行处理,右侧输出向量索引、文本索引或混合索引,底部由监控与容错层兜底。
核心能力
| 能力模块 | 说明 | 用户价值 |
|---|---|---|
| 分布式索引构建 | 基于 MapReduce 并行处理海量数据 | 构建更快、扩展更强 |
| 向量索引 | 支持向量相似度检索 | 适配 AI 搜索、召回、推荐 |
| 文本索引 | 支持关键词、倒排、全文检索 | 提升搜索准确率 |
| 滚动建库 | 索引更新不影响线上服务 | 持续可用、平滑升级 |
| 高可靠保障 | 任务重试、容错、数据校验 | 降低失败风险 |
| 低改造成本 | 兼容现有服务架构 | 快速上线、减少人力投入 |
分布式构建怎么跑:5 个阶段
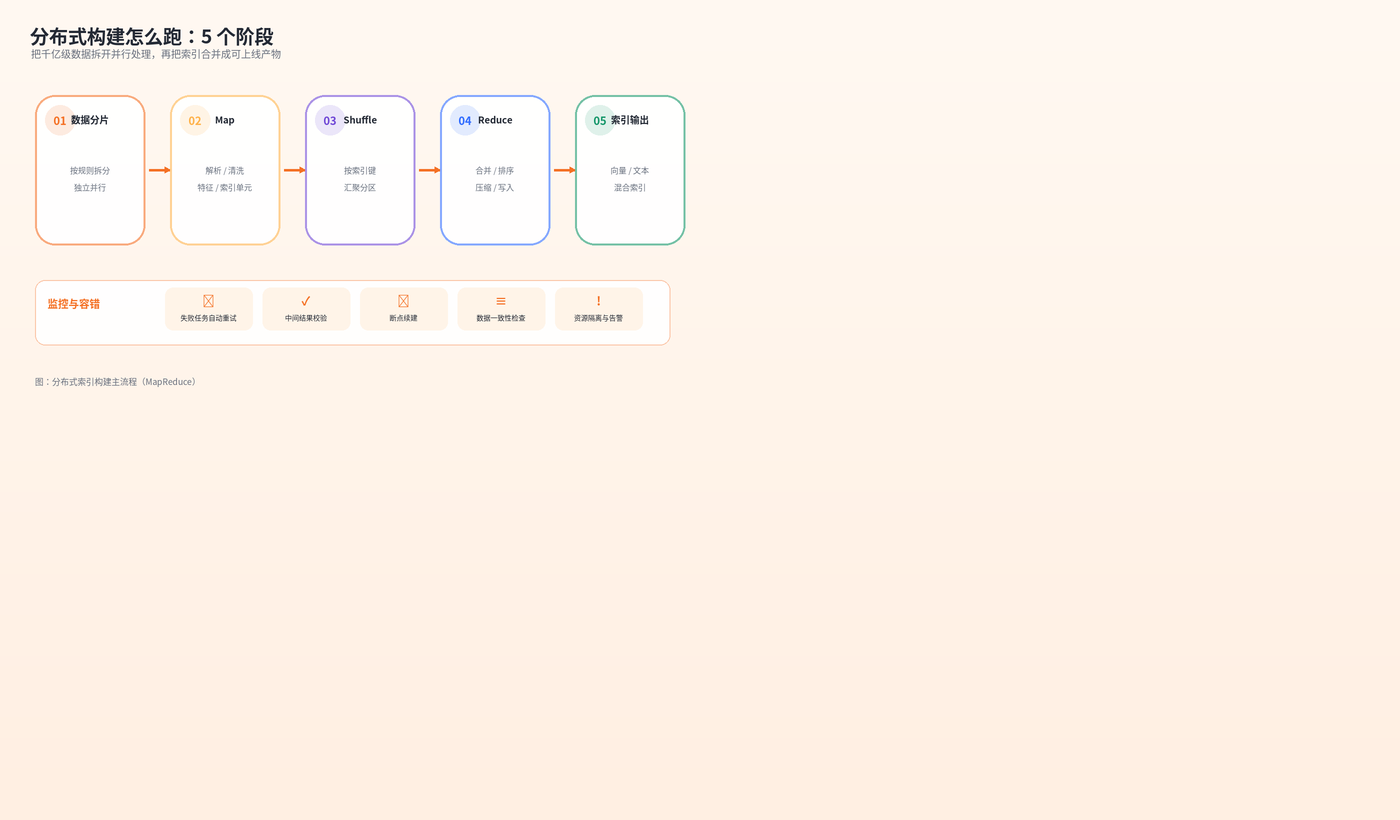
- 数据分片:将千亿级数据按规则拆分为多个独立分片,分发到不同计算节点并行处理。
- Map 阶段:对每个分片进行解析、清洗、特征提取,生成索引单元。
- Shuffle 阶段:把相同索引键或向量分区的数据汇聚到对应 Reduce 节点。
- Reduce 阶段:完成索引合并、排序、压缩、分区写入。
- 索引输出:生成向量索引、文本索引或混合索引,写入目标存储与检索引擎。
构建全过程由监控与容错层跟踪:任务进度、失败节点、数据完整性、构建耗时都可见。
MapReduce 复杂环境,怎么保证不翻车
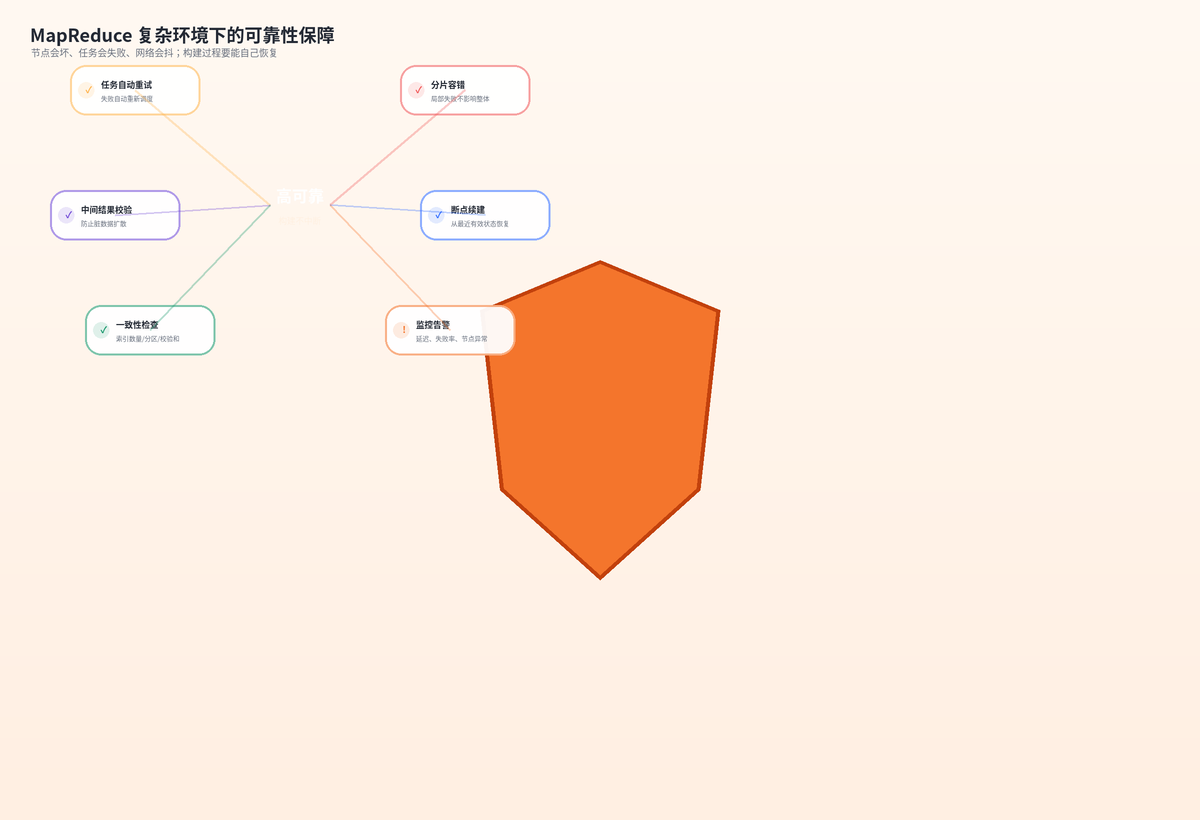
节点故障、数据倾斜、任务重试、网络抖动,在大规模分布式环境里都是常态。平台从任务、分片、数据、资源和监控五个层面做保障:
| 可靠性能力 | 解决的问题 |
|---|---|
| 任务自动重试 | 失败任务自动重新调度,避免单点故障导致整体失败 |
| 分片级容错 | 每个分片独立处理,局部失败不影响其他分片 |
| 中间结果校验 | 对 Map / Reduce 输出做完整性校验,防止脏数据扩散 |
| 断点续建 | 构建中断后从最近有效状态恢复,不必从头开始 |
| 数据一致性检查 | 构建完成后比对索引数量、分区数量、校验和 |
| 资源隔离与限流 | 避免构建任务占用过多集群资源,影响线上业务 |
| 监控告警 | 对任务延迟、失败率、数据缺失、节点异常实时监控 |
原有服务需要重写吗?不需要
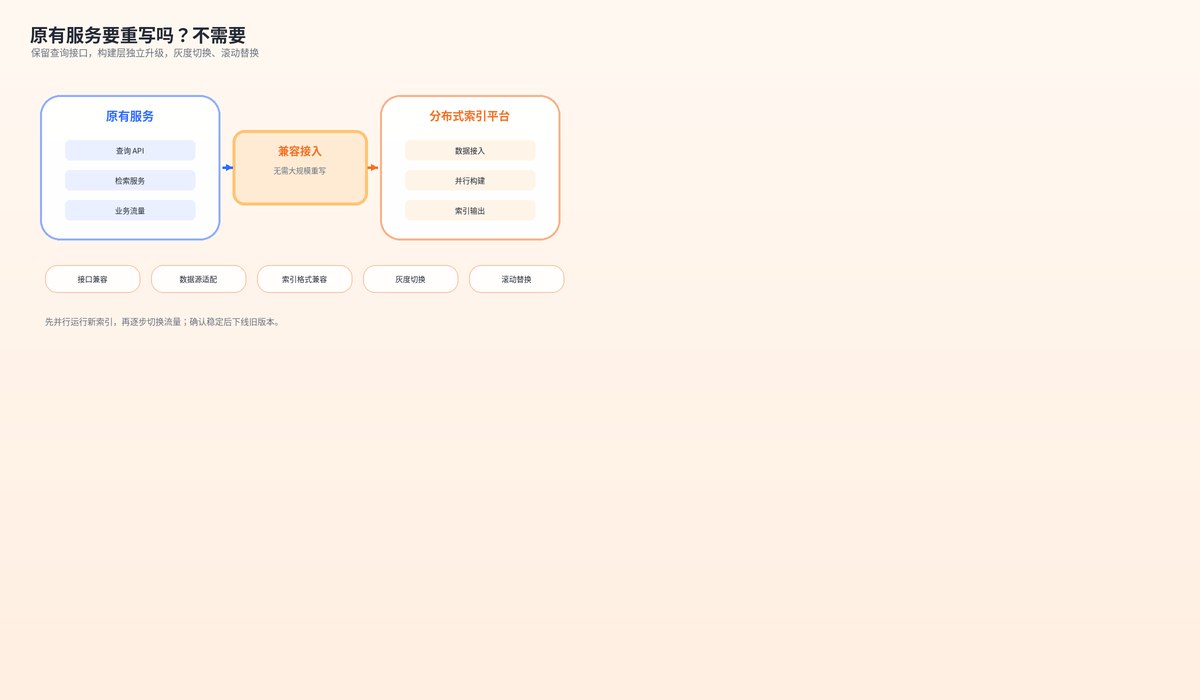
平台采用兼容接入方式,原有服务不需要大规模重写:
- 接口兼容:保留现有查询接口,索引构建层独立升级;
- 数据源适配:支持从现有数据管道、HDFS、消息队列或数据库接入;
- 索引格式兼容:可按现有检索引擎格式输出索引文件;
- 灰度切换:先构建新索引,再逐步切换流量;
- 滚动替换:旧索引与新索引并行运行,确认稳定后再下线旧版本。
整体改造集中在数据接入适配、索引格式确认和灰度验证,不需要对业务服务做颠覆性重构。
滚动建库:不停服、可回滚、数据更新更快
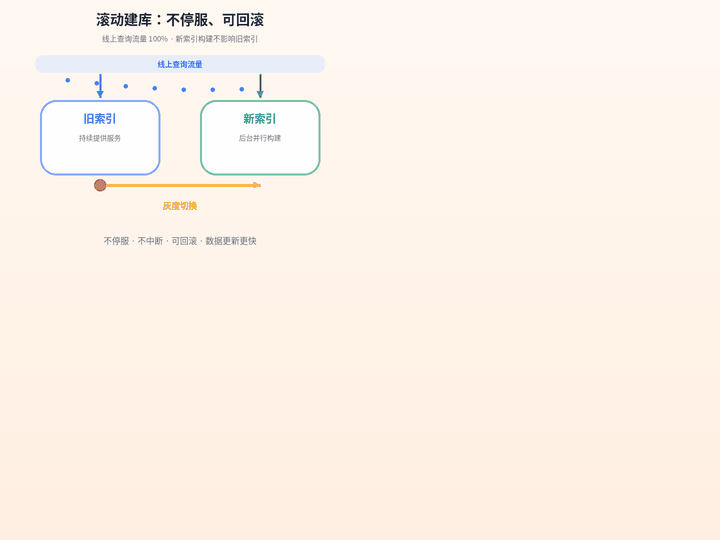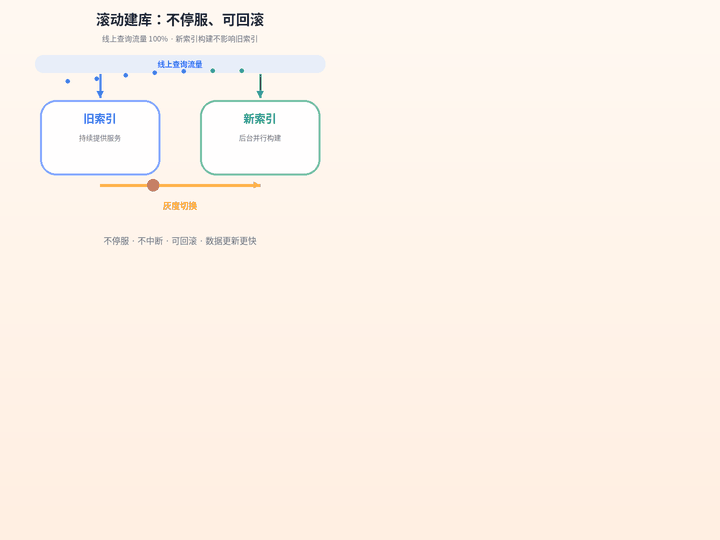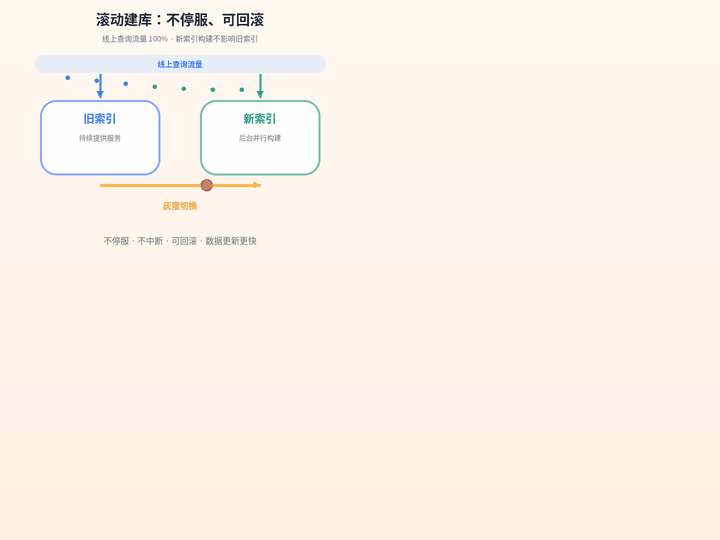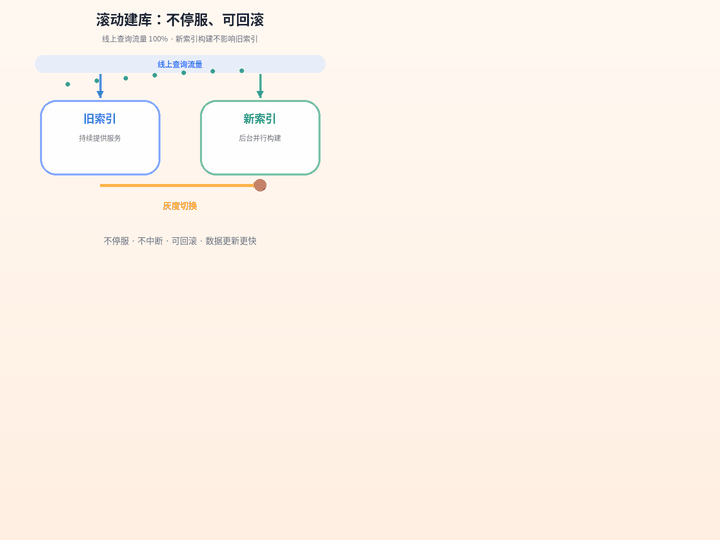
滚动建库把“构建”和“发布”拆开:新索引在后台构建,旧索引继续服务;构建完成后通过灰度切换逐步导流,确认稳定后下线旧版本。
| 维度 | 传统全量重建 | 分布式滚动建库 |
|---|---|---|
| 构建方式 | 单机 / 小集群串行 | 分片并行 + MapReduce |
| 线上影响 | 容易挤占资源 | 新旧索引并行,流量无感 |
| 失败恢复 | 容易从头再来 | 断点续建 + 任务重试 |
| 发布风险 | 一次性切换 | 灰度切换、可回滚 |
| 数据新鲜度 | 更新周期长 | 增量更新、缩短延迟 |
| 改造成本 | 需要大改 | 接口兼容、逐步接入 |
适用场景
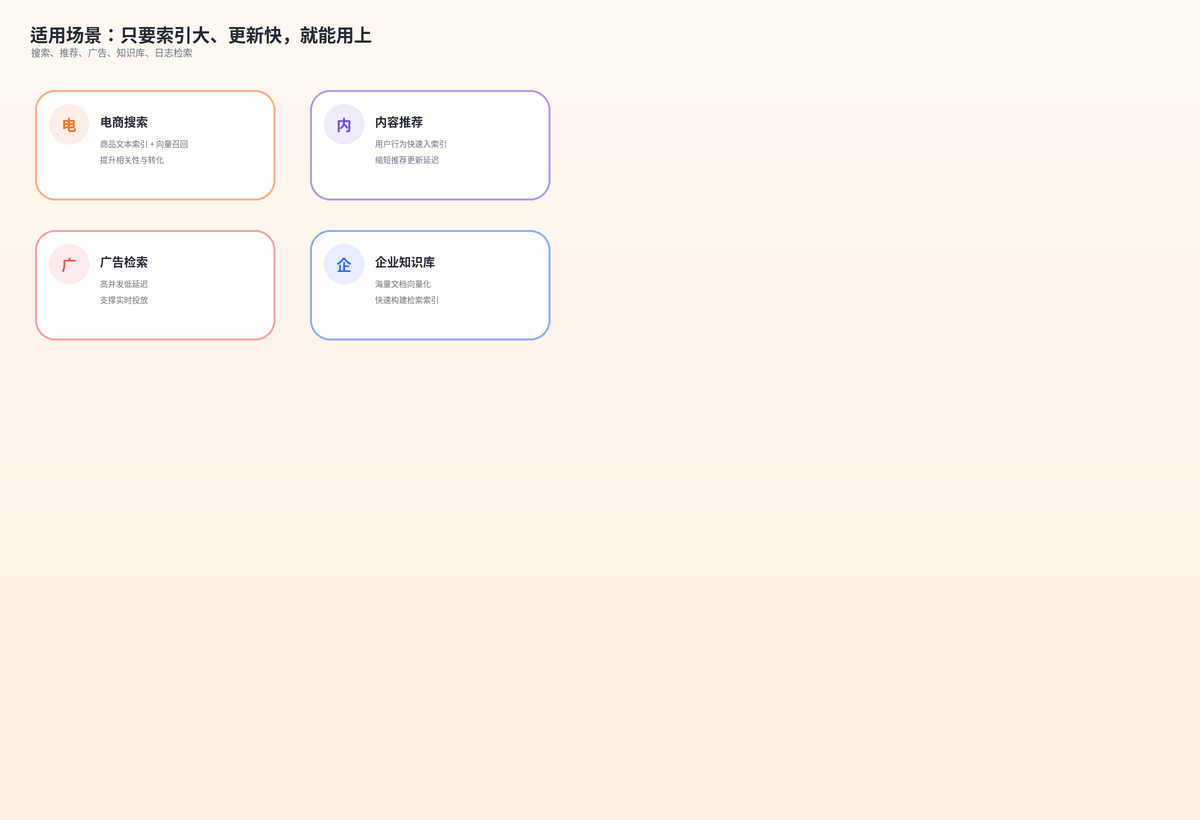
- 电商搜索:商品文本索引 + 向量召回,提升搜索相关性与转化;
- 内容推荐:用户行为数据快速入索引,缩短推荐更新延迟;
- 广告检索:高并发、低延迟索引构建,支撑实时投放;
- 企业知识库:海量文档向量化后快速构建检索索引;
- 日志与数据检索:大规模文本索引快速生成与更新。
服务交付清单
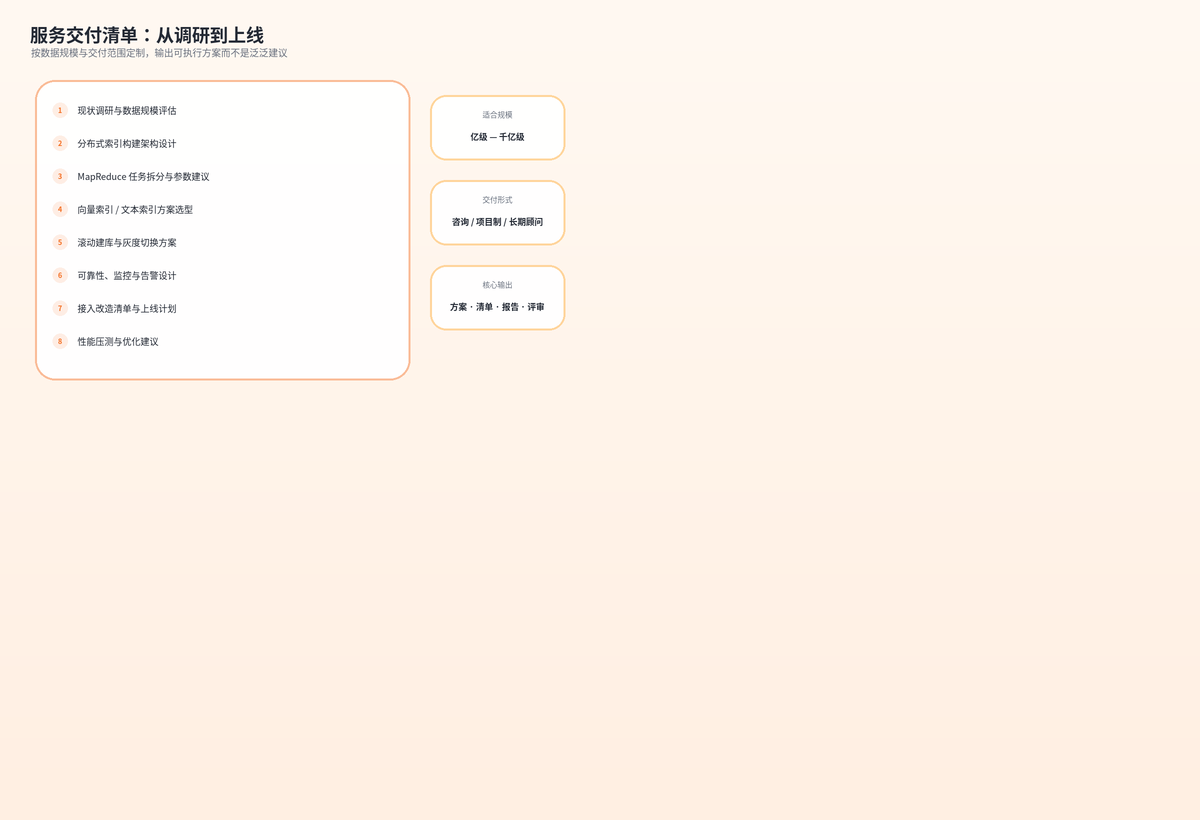
| 交付项 | 交付内容 |
|---|---|
| 现状调研 | 数据规模、索引类型、集群资源、现有链路与瓶颈评估 |
| 架构设计 | 分布式索引构建架构、分片策略、任务拆分与资源规划 |
| 参数建议 | MapReduce 任务参数、并行度、分片大小、失败重试策略 |
| 索引选型 | 向量索引、文本索引、混合索引的选型与组合建议 |
| 滚动建库 | 双索引并行、灰度切换、回滚与增量更新方案 |
| 可靠性设计 | 任务重试、断点续建、数据校验、监控告警 |
| 接入清单 | 数据源适配、接口兼容、上线步骤与风险点 |
| 性能验证 | 构建耗时、资源占用、失败率、索引完整性与压测建议 |
为什么选择本服务
- 面向千亿级规模设计:不是小数据量 demo,而是按大规模集群与生产链路考虑;
- 构建速度目标 10x+:通过分布式并行构建缩短索引生成时间(以实际数据与集群规模为准);
- 多索引能力:向量索引、文本索引、混合索引统一规划;
- 可靠性与工程化:任务重试、断点续建、数据校验、监控告警一起设计;
- 低改造成本:接口兼容、灰度切换、滚动替换,原有服务不需要大规模重写。
常见问题
Q1:一定要千亿级才能用吗?
不是。亿级、十亿级同样适用,只是分片规模、集群资源和构建参数不同。方案会按你的实际数据量设计。
Q2:一定要上 Hadoop 吗?
平台基于 Hadoop MapReduce 实现,适合已有大数据集群的团队。没有现成集群也可以评估资源与接入方式。
Q3:原有服务需要重写吗?
通常不需要。保留现有查询接口,构建层独立升级;通过数据源适配、索引格式兼容和灰度切换逐步接入。
Q4:构建期间会影响线上查询吗?
滚动建库支持新旧索引并行,构建过程不直接替换线上索引;通过资源隔离、限流和灰度切换降低影响。
Q5:任务失败了怎么办?
支持任务自动重试、分片级容错和断点续建;失败分片可以单独恢复,不必全量重跑。
Q6:支持哪些索引?
支持向量索引、文本索引,并可扩展混合索引能力;具体选型按召回、延迟、内存和成本约束确定。
Q7:交付周期多久?
取决于数据规模、现有链路完整度和交付范围。首次沟通后会给出工作范围、交付物和时间表。
Q8:价格怎么算?
本商品为咨询启动金(9.9 元),用于预约首次需求沟通。项目费用按数据规模、问题复杂度和交付范围单独评估。
购买说明
- 支持单次咨询、项目制服务、长期顾问;
- 可按数据规模、问题复杂度、交付周期定制方案;
- 提供架构方案、接入清单、调优报告、评审报告等交付物;
- 适合搜索、推荐、广告、AI 平台、数据平台团队。
下一步:下单后请留下数据规模、索引类型、现有集群与主要痛点,我们会先做一次需求梳理,再确认是否进入正式咨询。
把索引更新变成一件更快、更稳、更省成本的事。
相关产品
FAISS 向量检索技术咨询|百亿级架构 · HNSW/IVFPQ 调优
面向 RAG、语义搜索、推荐召回与大规模向量检索的 FAISS 技术咨询:索引选型、HNSW/IVFPQ 调优、百亿级分布式构建、源码级问题排查与团队内训。 ¥9.90