- ×
 FAISS 向量检索技术咨询|百亿级架构 · HNSW/IVFPQ 调优 1 × ¥9.90
购物小计: ¥9.90
加载中
FAISS 向量检索技术咨询|百亿级架构 · HNSW/IVFPQ 调优 1 × ¥9.90购物小计: ¥9.90
¥9.90
面向搜索、推荐、广告、向量检索等场景,提供基于 Hadoop MapReduce 的千亿级分布式索引构建咨询:架构设计、可靠性保障、滚动建库、低改造成本接入与性能优化。
千亿级数据,索引构建不该成为业务上线和迭代的瓶颈。
面向搜索、推荐、广告、向量检索、企业知识库等场景,提供基于 Hadoop MapReduce 的千亿级分布式索引构建咨询。覆盖架构设计、任务拆分、可靠性保障、滚动建库、低成本接入与性能优化。
不只讲“分布式”概念,而是围绕你的数据规模、索引类型、集群资源和上线节奏,给出可执行的架构、参数、接入清单和灰度切换路径。
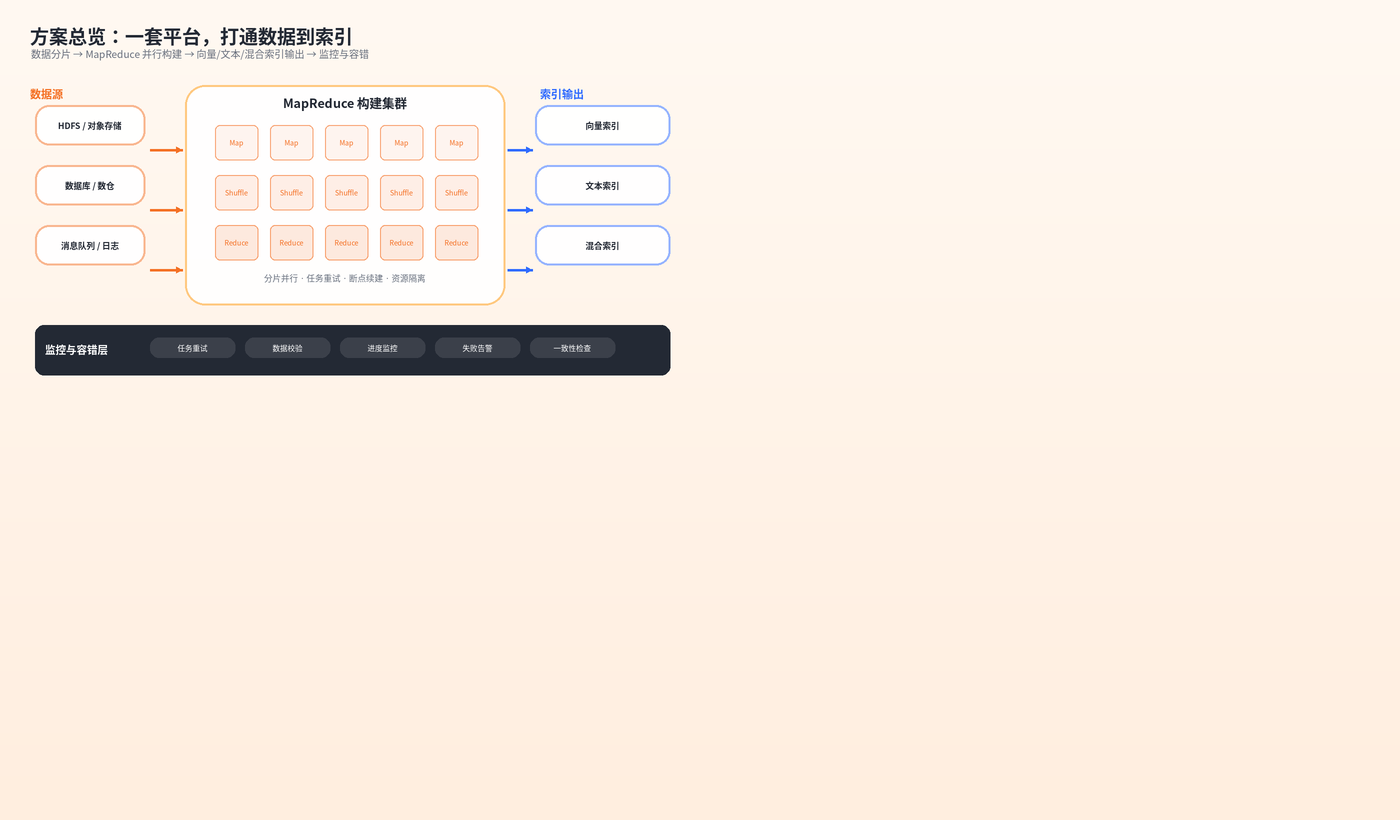
平台把“数据接入、分片、并行构建、索引输出、监控容错”串成一条完整链路:左侧接现有数据源,中间用 MapReduce 集群并行处理,右侧输出向量索引、文本索引或混合索引,底部由监控与容错层兜底。
| 能力模块 | 说明 | 用户价值 |
|---|---|---|
| 分布式索引构建 | 基于 MapReduce 并行处理海量数据 | 构建更快、扩展更强 |
| 向量索引 | 支持向量相似度检索 | 适配 AI 搜索、召回、推荐 |
| 文本索引 | 支持关键词、倒排、全文检索 | 提升搜索准确率 |
| 滚动建库 | 索引更新不影响线上服务 | 持续可用、平滑升级 |
| 高可靠保障 | 任务重试、容错、数据校验 | 降低失败风险 |
| 低改造成本 | 兼容现有服务架构 | 快速上线、减少人力投入 |
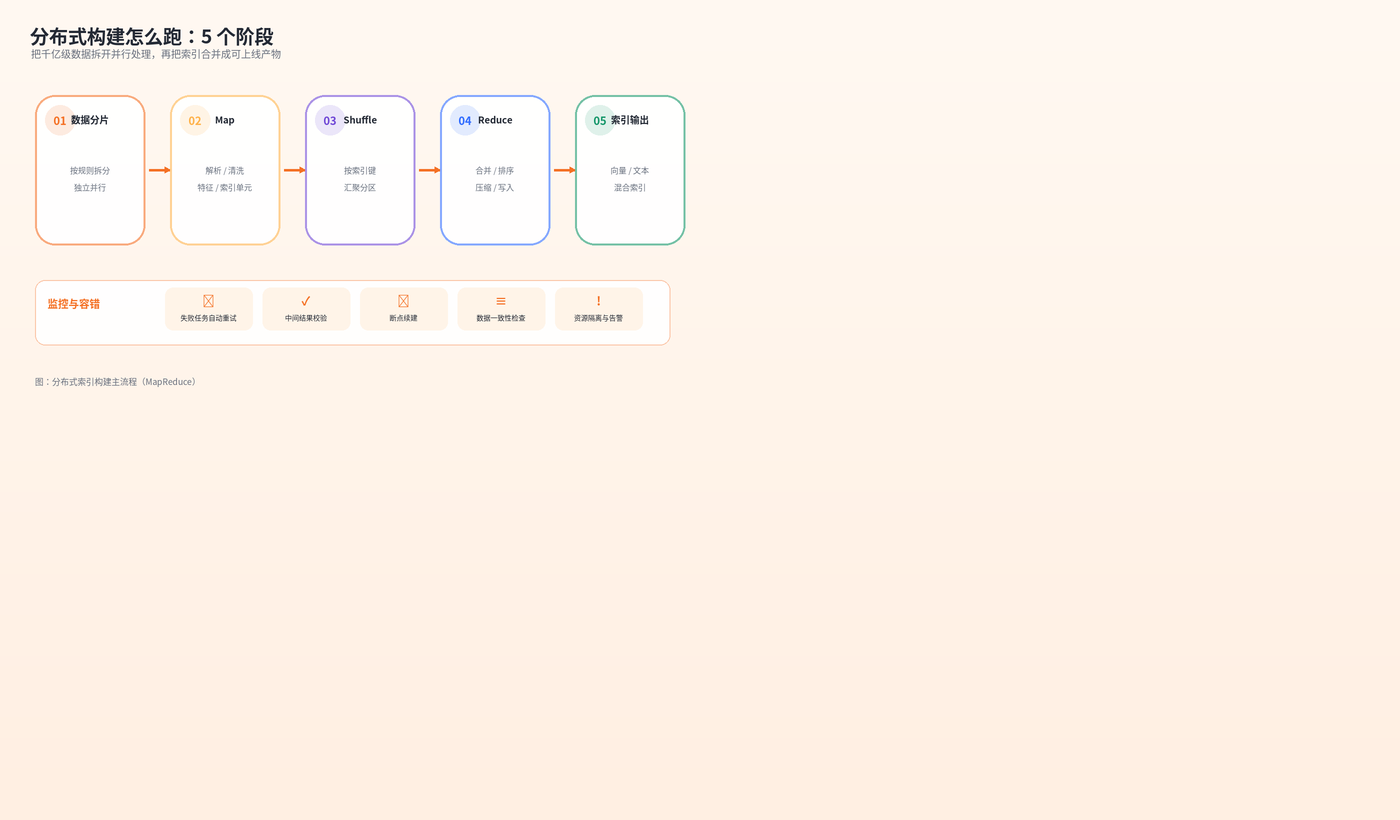
构建全过程由监控与容错层跟踪:任务进度、失败节点、数据完整性、构建耗时都可见。
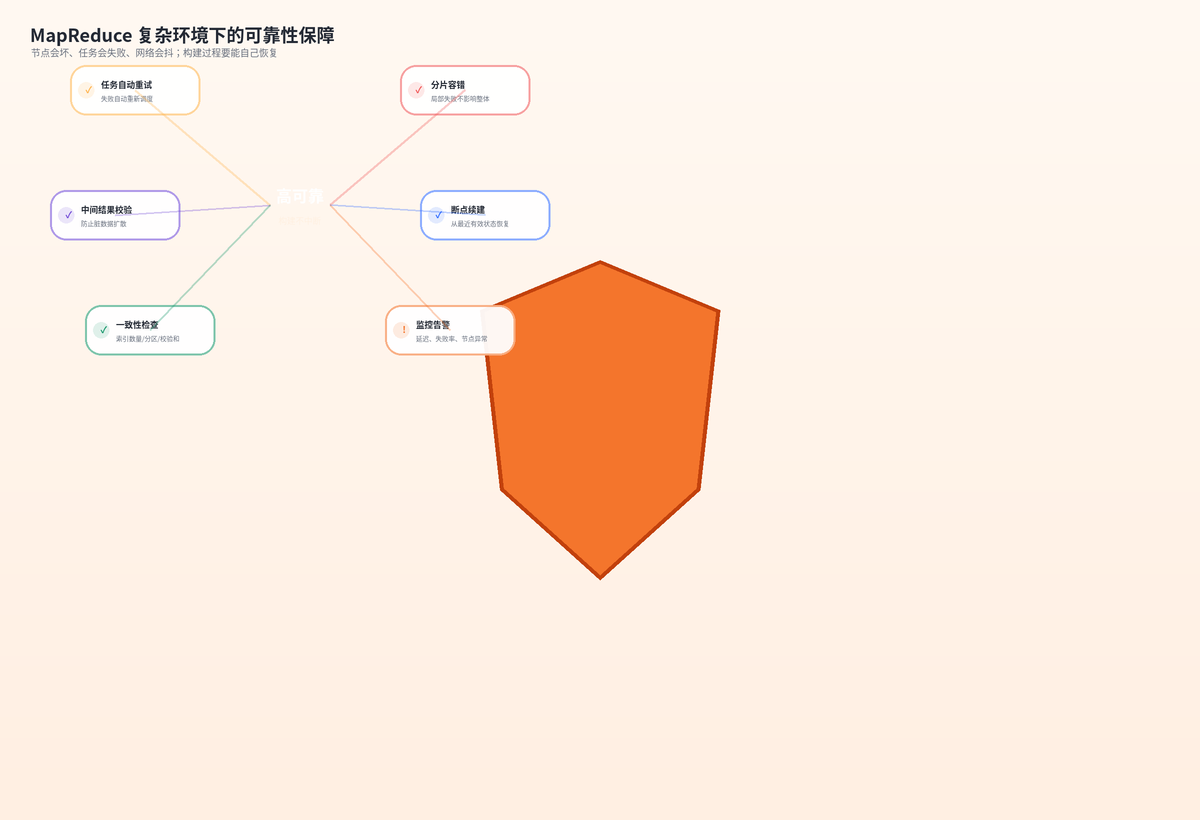
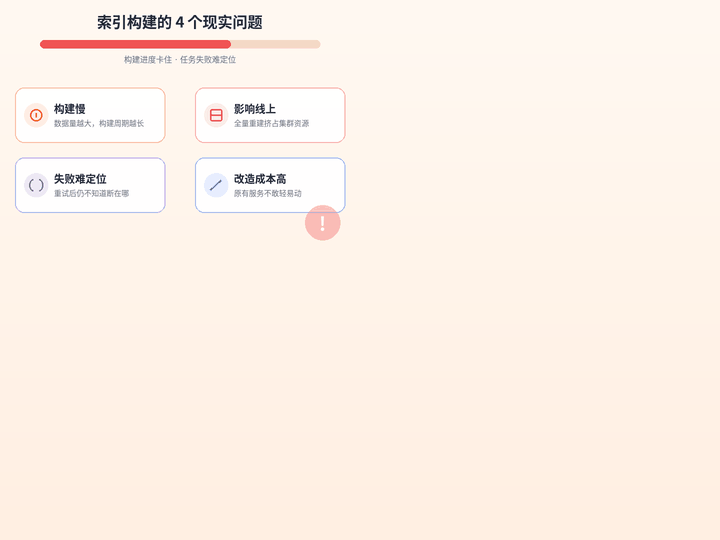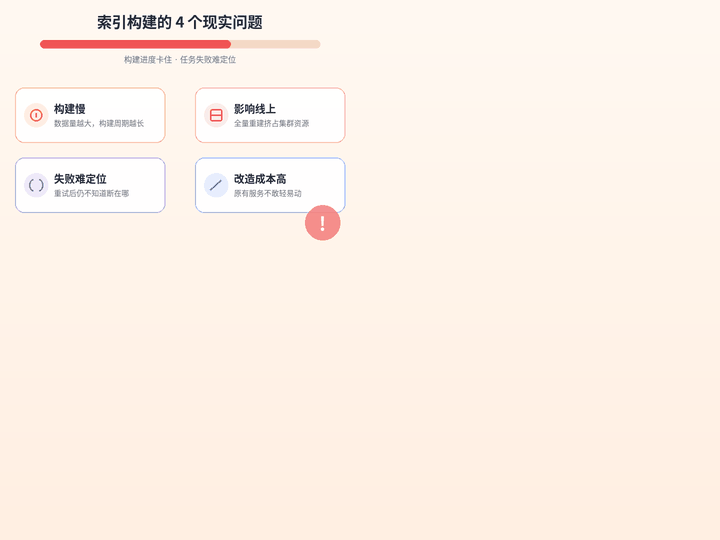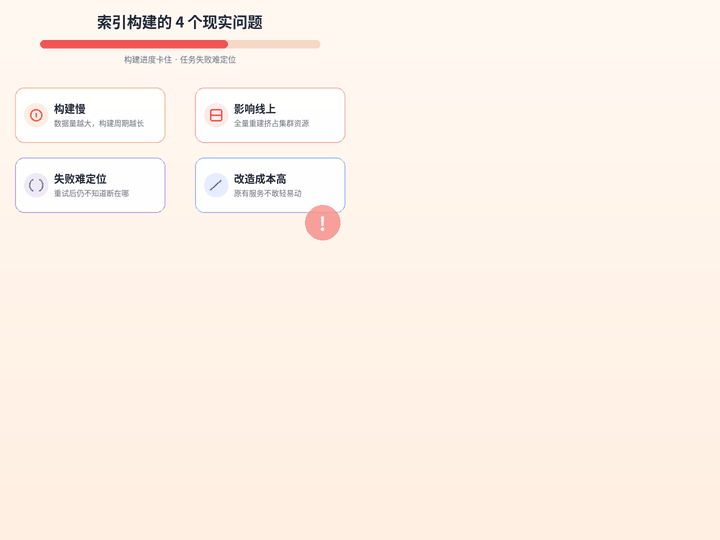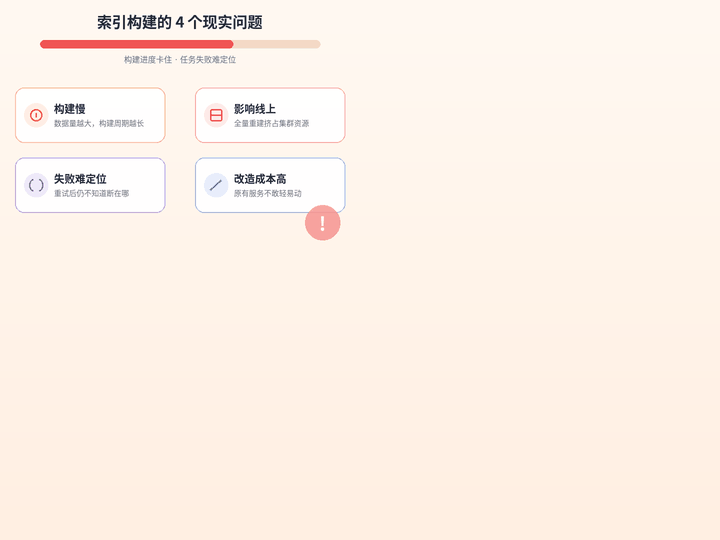
节点故障、数据倾斜、任务重试、网络抖动,在大规模分布式环境里都是常态。平台从任务、分片、数据、资源和监控五个层面做保障:
| 可靠性能力 | 解决的问题 |
|---|---|
| 任务自动重试 | 失败任务自动重新调度,避免单点故障导致整体失败 |
| 分片级容错 | 每个分片独立处理,局部失败不影响其他分片 |
| 中间结果校验 | 对 Map / Reduce 输出做完整性校验,防止脏数据扩散 |
| 断点续建 | 构建中断后从最近有效状态恢复,不必从头开始 |
| 数据一致性检查 | 构建完成后比对索引数量、分区数量、校验和 |
| 资源隔离与限流 | 避免构建任务占用过多集群资源,影响线上业务 |
| 监控告警 | 对任务延迟、失败率、数据缺失、节点异常实时监控 |
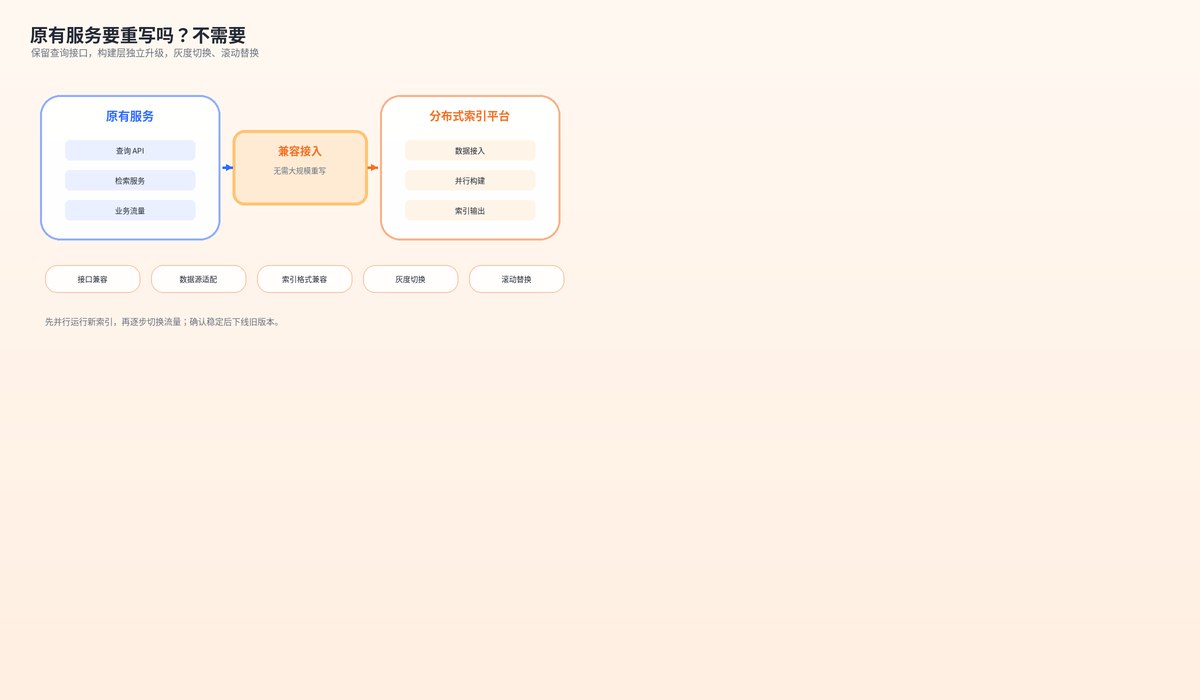
平台采用兼容接入方式,原有服务不需要大规模重写:
整体改造集中在数据接入适配、索引格式确认和灰度验证,不需要对业务服务做颠覆性重构。
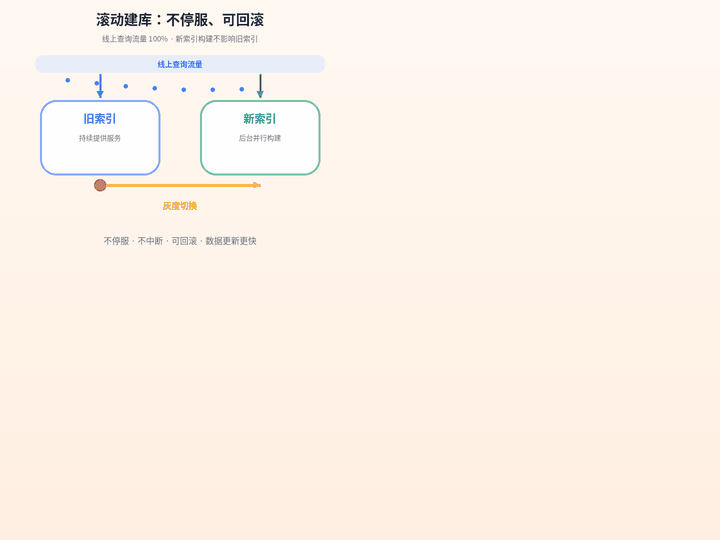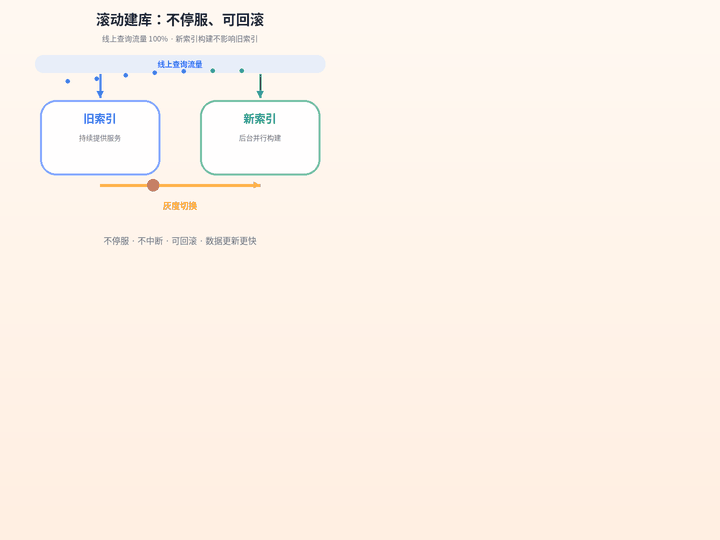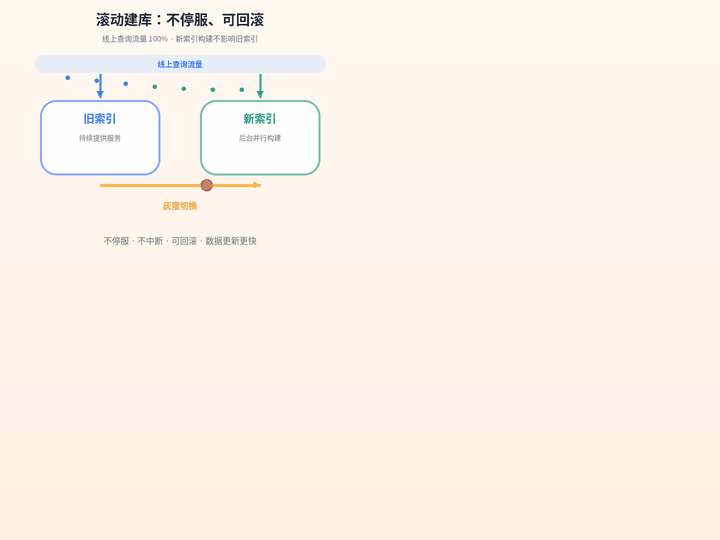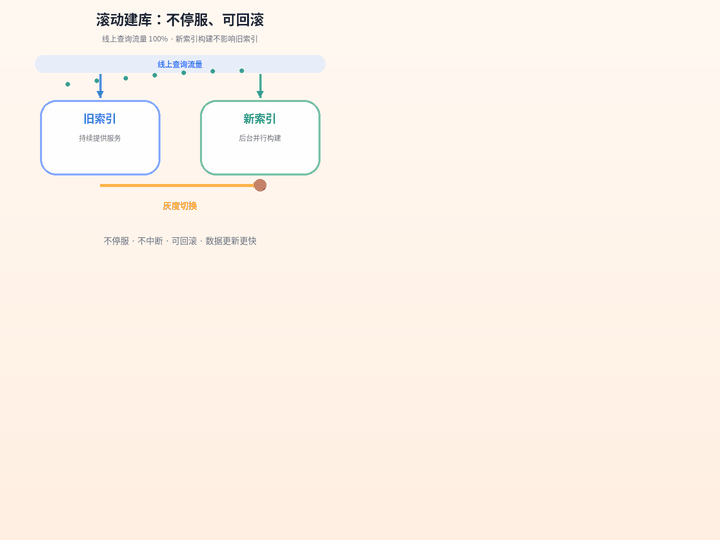
滚动建库把“构建”和“发布”拆开:新索引在后台构建,旧索引继续服务;构建完成后通过灰度切换逐步导流,确认稳定后下线旧版本。
| 维度 | 传统全量重建 | 分布式滚动建库 |
|---|---|---|
| 构建方式 | 单机 / 小集群串行 | 分片并行 + MapReduce |
| 线上影响 | 容易挤占资源 | 新旧索引并行,流量无感 |
| 失败恢复 | 容易从头再来 | 断点续建 + 任务重试 |
| 发布风险 | 一次性切换 | 灰度切换、可回滚 |
| 数据新鲜度 | 更新周期长 | 增量更新、缩短延迟 |
| 改造成本 | 需要大改 | 接口兼容、逐步接入 |
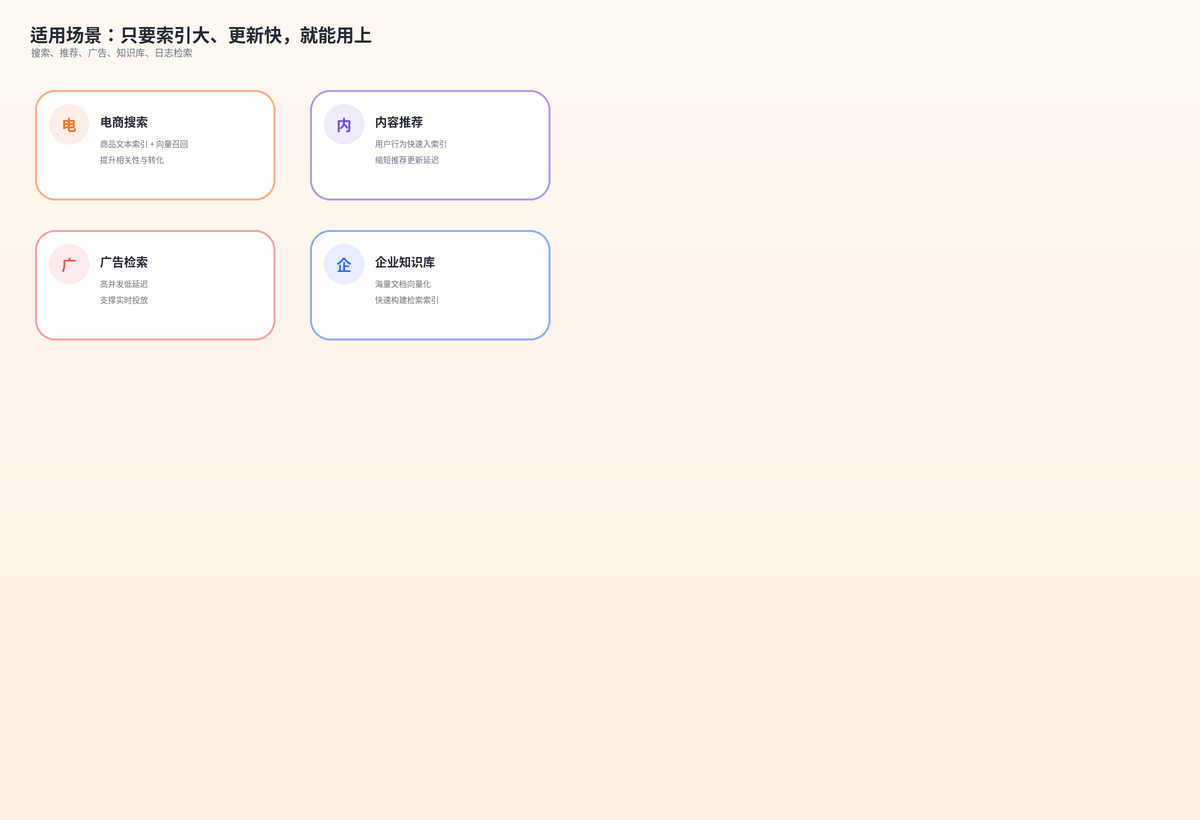
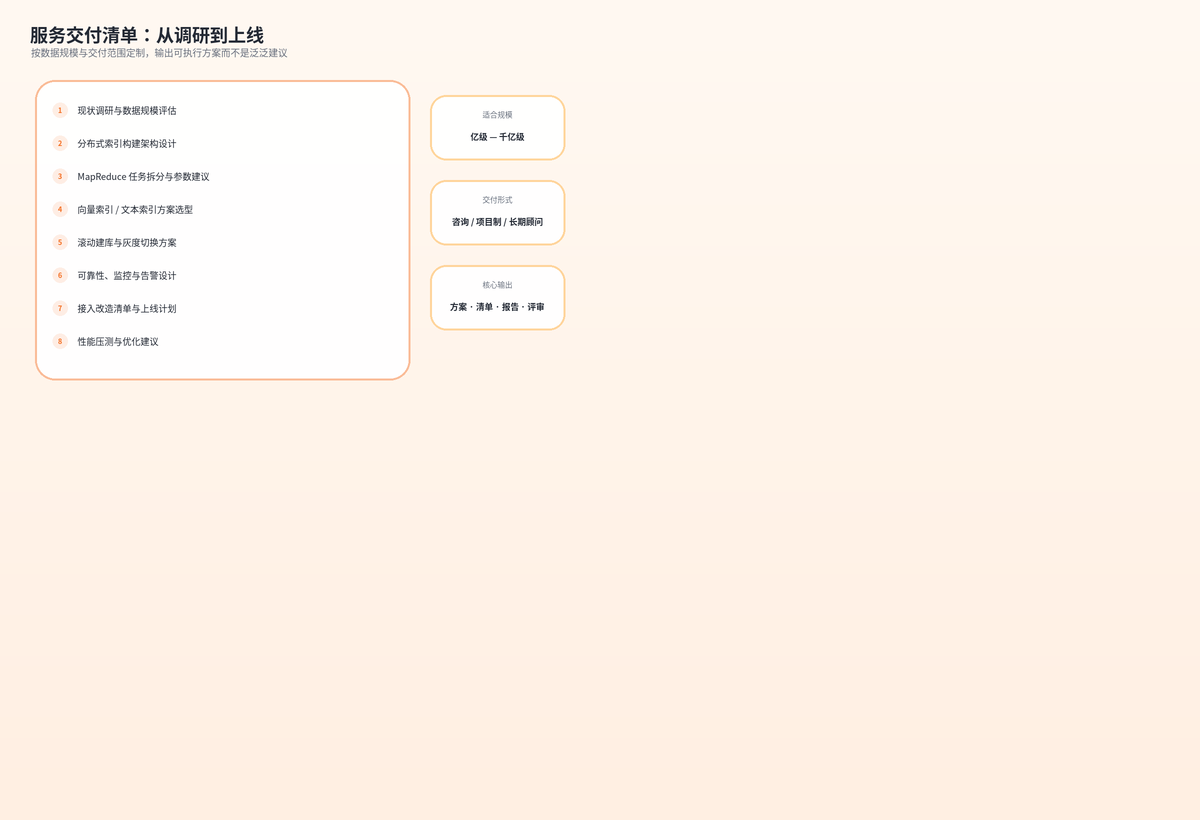
| 交付项 | 交付内容 |
|---|---|
| 现状调研 | 数据规模、索引类型、集群资源、现有链路与瓶颈评估 |
| 架构设计 | 分布式索引构建架构、分片策略、任务拆分与资源规划 |
| 参数建议 | MapReduce 任务参数、并行度、分片大小、失败重试策略 |
| 索引选型 | 向量索引、文本索引、混合索引的选型与组合建议 |
| 滚动建库 | 双索引并行、灰度切换、回滚与增量更新方案 |
| 可靠性设计 | 任务重试、断点续建、数据校验、监控告警 |
| 接入清单 | 数据源适配、接口兼容、上线步骤与风险点 |
| 性能验证 | 构建耗时、资源占用、失败率、索引完整性与压测建议 |
不是。亿级、十亿级同样适用,只是分片规模、集群资源和构建参数不同。方案会按你的实际数据量设计。
平台基于 Hadoop MapReduce 实现,适合已有大数据集群的团队。没有现成集群也可以评估资源与接入方式。
通常不需要。保留现有查询接口,构建层独立升级;通过数据源适配、索引格式兼容和灰度切换逐步接入。
滚动建库支持新旧索引并行,构建过程不直接替换线上索引;通过资源隔离、限流和灰度切换降低影响。
支持任务自动重试、分片级容错和断点续建;失败分片可以单独恢复,不必全量重跑。
支持向量索引、文本索引,并可扩展混合索引能力;具体选型按召回、延迟、内存和成本约束确定。
取决于数据规模、现有链路完整度和交付范围。首次沟通后会给出工作范围、交付物和时间表。
本商品为咨询启动金(9.9 元),用于预约首次需求沟通。项目费用按数据规模、问题复杂度和交付范围单独评估。
下一步:下单后请留下数据规模、索引类型、现有集群与主要痛点,我们会先做一次需求梳理,再确认是否进入正式咨询。
把索引更新变成一件更快、更稳、更省成本的事。