购物车中没有产品。
FAISS 向量检索技术咨询|百亿级架构 · HNSW/IVFPQ 调优
¥9.90
面向 RAG、语义搜索、推荐召回与大规模向量检索的 FAISS 技术咨询:索引选型、HNSW/IVFPQ 调优、百亿级分布式构建、源码级问题排查与团队内训。
描述
FAISS 用起来不难,难的是在生产环境里做到「召回稳、延迟低、内存可控、构建跟得上」。
如果你正在搭建 RAG 知识库、语义搜索、推荐召回、图片/视频检索、商品相似搜索,或者已经上线 FAISS 却遇到索引构建慢、查询延迟抖动、内存占用高、召回率不稳定,这项咨询就是为你的团队准备的。
我们不做泛泛的概念科普,而是围绕你的数据规模、业务指标和现有架构,给出可执行的索引选型、参数调优、分布式构建与源码级排查方案。
你可能正在经历这些问题
- 数据量从百万级涨到亿级后,索引构建时间越来越不可控;
- HNSW 参数试了很多组,召回率和延迟始终找不到平衡点;
- IVF / PQ / IVFPQ 的 nlist、nprobe、码本大小不知道怎么定;
- 查询 P99 延迟抖动,线上流量一上来就不稳定;
- 内存占用远超预算,扩容成本比预期高很多;
- 召回率下降,但不知道问题出在向量质量、索引参数还是查询链路;
- 单机 FAISS 已经撑不住,想升级到分布式检索但缺少架构经验;
- 团队需要一次系统的 FAISS 内训或架构评审,把问题讲透。
为什么选择这项服务
1. 源码级理解,不只停留在「调参」
阅读过 FAISS 源码,梳理过索引构建、查询、距离计算、量化等关键流程,能够结合流程图和源码标注定位问题。面对「构建异常、召回下降、延迟抖动、内存暴涨」这类疑难问题,不是靠猜参数,而是从链路和实现层面找原因。
2. 百亿级数据实战经验
基于 FAISS 开发过支持百亿级数据的搜索服务,具备分布式构建服务经验,并对 HNSW 做过分布式构建优化,构建速度提升数倍。大规模场景下的分片、路由、合并、增量更新和冷热分层,都有实际落地经验。
3. 索引与性能优化经验覆盖完整
熟悉 HNSW、IVF、PQ、IVFPQ、HNSWPQ 等索引结构,对距离计算、中心点训练、量化误差、召回率、延迟、内存占用、并发查询等有较多实战经验。能根据你的数据规模、内存预算和延迟目标,给出匹配的索引组合,而不是只推荐「最热」的那一个。
4. 专利与方法论沉淀
发表过多篇向量检索相关专利,能够从算法、工程、系统架构多个角度提供解决方案。既关注「能不能跑」,也关注「能不能长期维护、能不能持续优化」。
5. 内部讲师经验,复杂问题讲得清楚
曾担任公司 FAISS 内部讲师,组织过多场技术分享,擅长把复杂问题讲清楚。适合团队培训、技术评审和架构辅导,也适合需要统一团队认知、推动方案落地的场景。
先看懂 HNSW:查询为什么快,瓶颈又在哪里
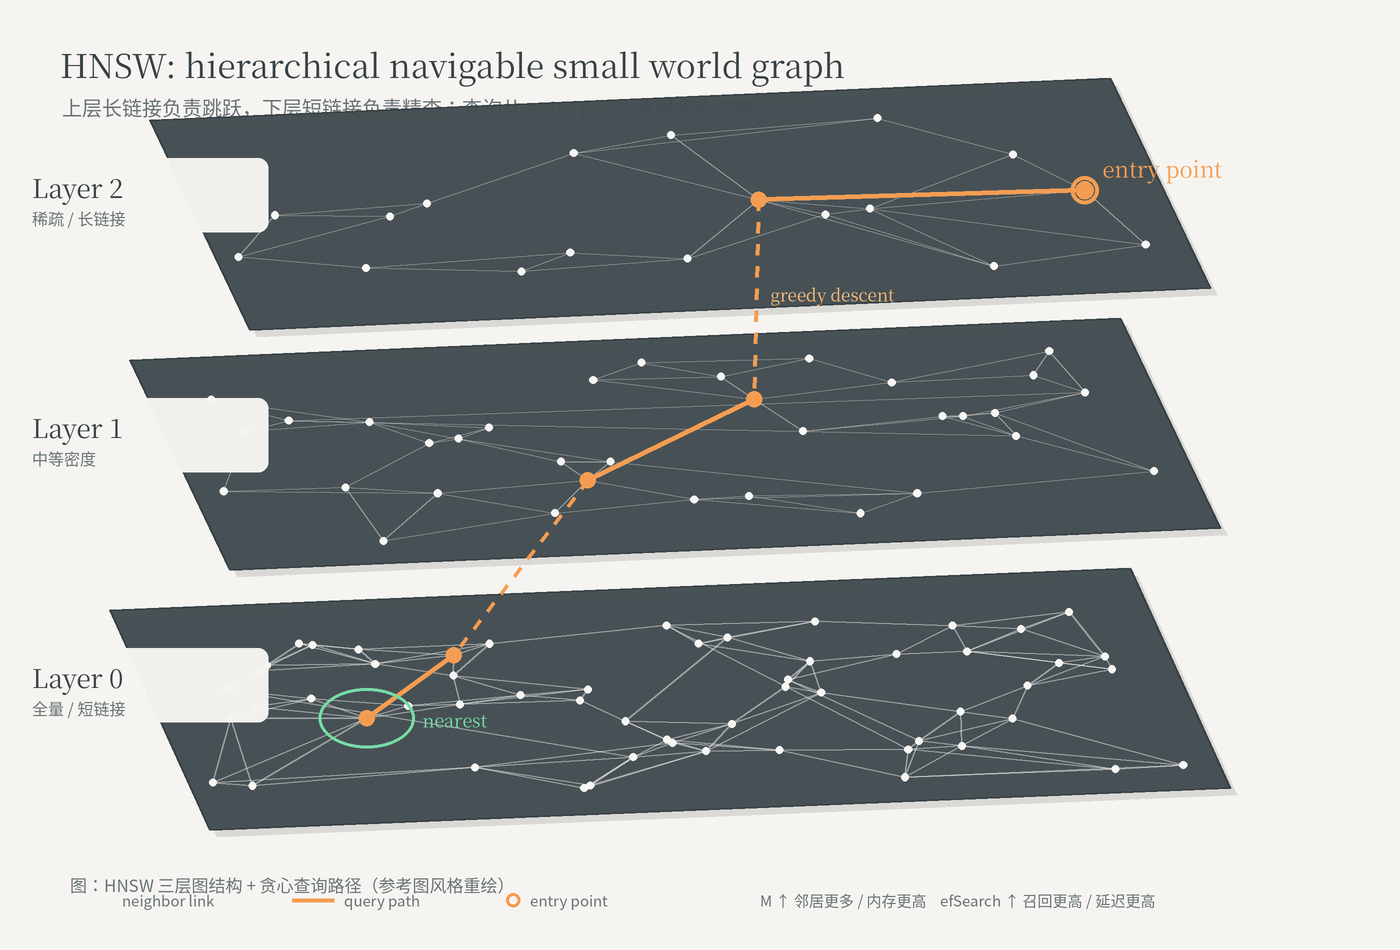
HNSW 用上层稀疏图做「导航」,下层全量图做「精查」。查询时从入口点进入,逐层向下寻找更近的邻居。它快,是因为避免了全量扫描;它也可能不稳,是因为 M、efConstruction、efSearch 以及数据分布都会影响图的质量。
我们会结合你的数据规模、查询 QPS、P99 延迟和召回目标,判断应该优先优化构建、查询还是内存,而不是给一组「看起来很大」的参数。
IVF 的中心点训练,决定了召回的下限
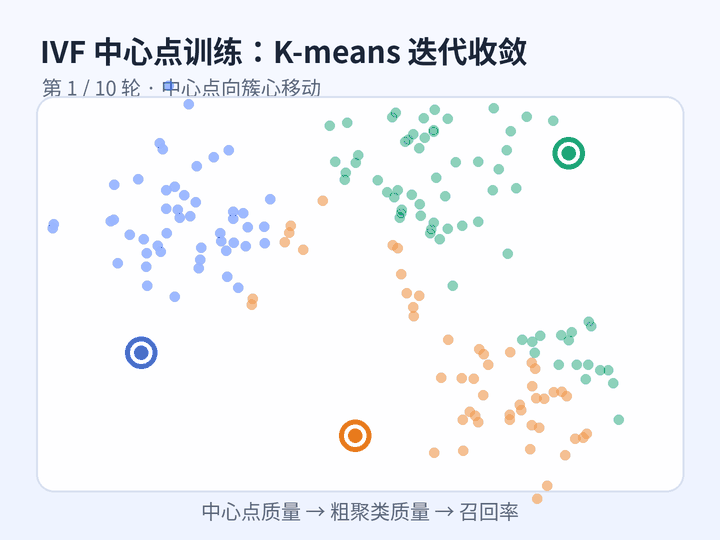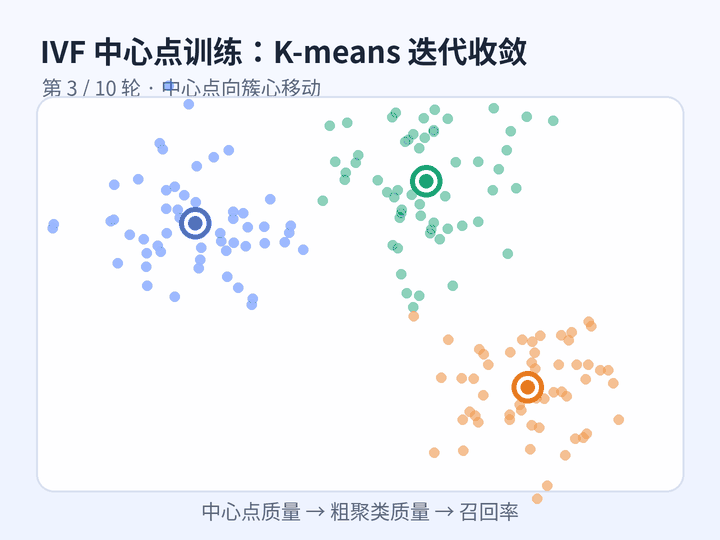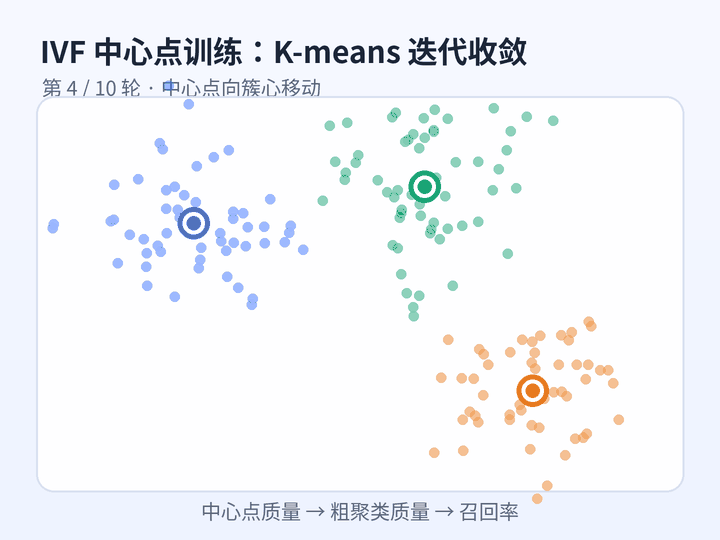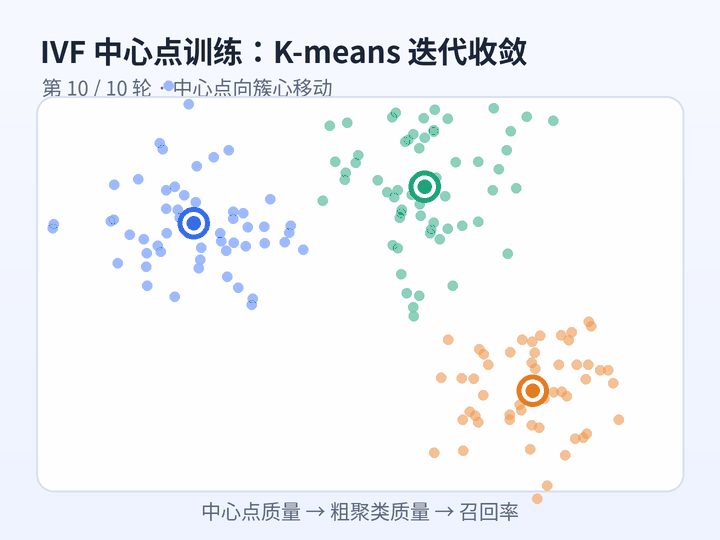
中心点不是随机定下来的。训练样本是否代表真实分布、聚类数量是否合理、迭代是否充分,都会影响倒排桶的划分质量。中心点偏了,后面的 nprobe 再大也可能「查不到该查的东西」。
我们会一起检查训练样本、聚类质量、量化误差和召回损失,找到「召回率、延迟、内存」三者之间真正可接受的平衡点。
索引选型:没有万能索引,只有匹配约束的组合
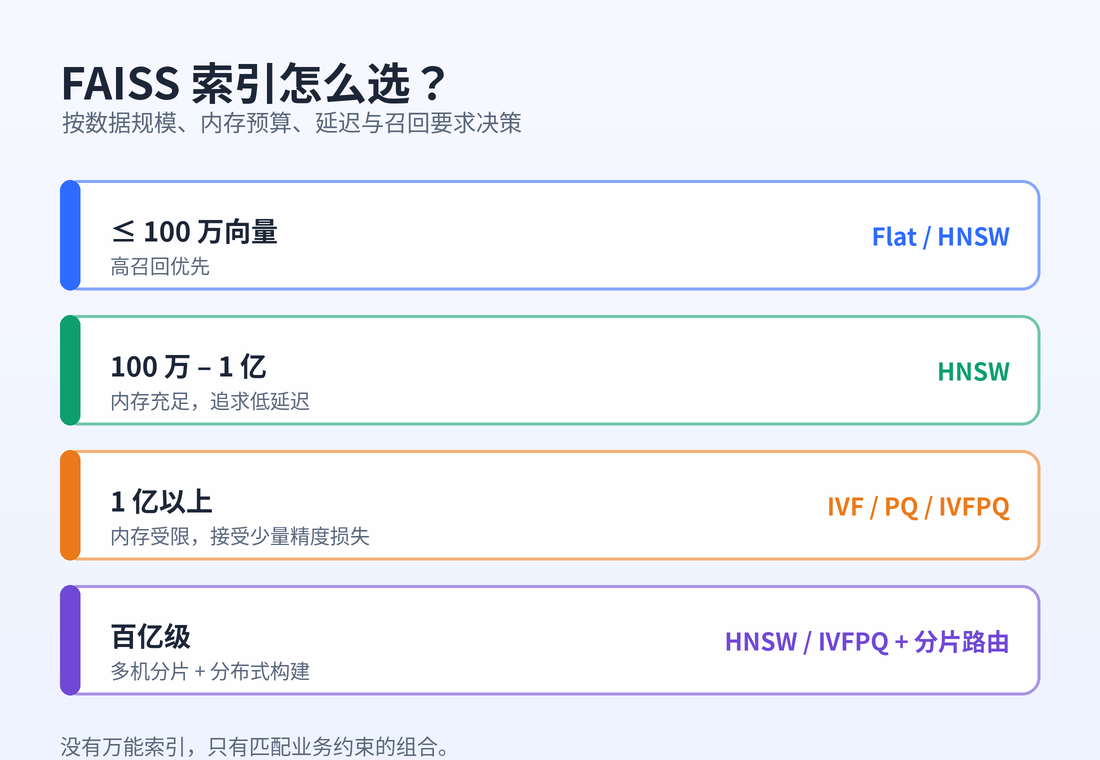
百万级高召回、亿级低延迟、内存受限、GPU 加速、百亿级分布式——不同约束对应不同答案。选型不是选一个索引就结束,而是要同时考虑:数据规模、更新频率、召回目标、P99 延迟、内存预算、构建窗口和运维成本。
从单机到百亿级:架构要一起升级
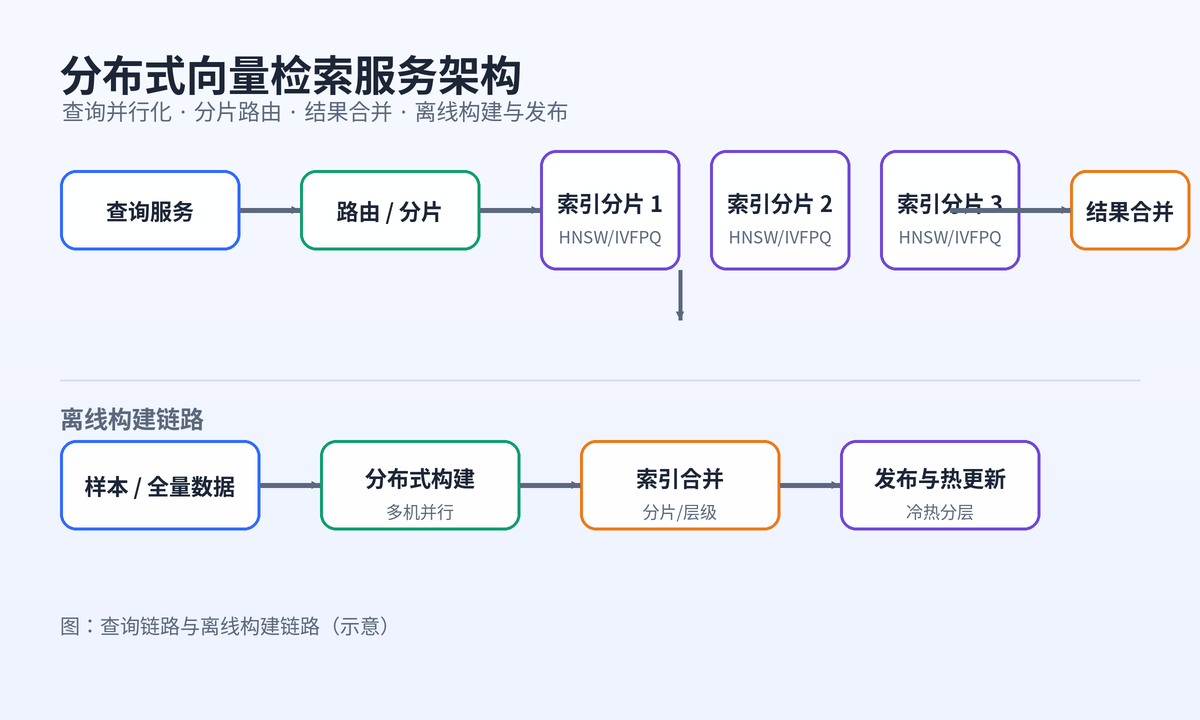
当数据量上来后,单机优化很快会碰到天花板。向量分片与路由、分布式索引构建、HNSW 分布式构建优化、索引合并、增量更新、冷热分层、查询并行化与结果合并,需要作为一个整体设计。
服务内容
| 服务项目 | 交付内容 | 适用场景 |
|---|---|---|
| 技术咨询 | 架构方案、索引选型、参数建议 | 项目初期或遇到瓶颈 |
| 性能优化 | 延迟、吞吐、内存、召回率优化 | 已上线但效果不理想 |
| 源码解读 | FAISS 流程图、源码标注、问题定位 | 深度排查疑难问题 |
| 分布式构建 | 百亿级检索架构、分布式 HNSW 方案 | 大规模数据场景 |
| 团队内训 | 课件、案例、答疑、实战讲解 | 团队能力建设 |
| 架构评审 | 方案评审、风险点分析、改进建议 | 上线前或重构前 |
服务流程
- 需求沟通:了解数据规模、业务场景、延迟要求、召回目标、现有架构和痛点。
- 问题诊断:分析索引结构、参数配置、构建流程、查询链路和性能瓶颈。
- 方案设计:提供索引选型、分布式架构、参数调优、资源评估和落地路径。
- 落地支持:协助参数调整、代码优化、索引构建优化和查询链路优化。
- 效果验证:对比召回率、延迟、吞吐、内存占用、构建时间等指标。
- 知识沉淀:输出文档、流程图、源码标注、培训材料或评审报告。
典型应用场景
- RAG 知识库检索:提升文档召回质量与响应速度;
- 语义搜索:优化长文本、多轮对话、复杂查询的召回;
- 商品相似搜索:支持大规模商品向量快速召回;
- 图片 / 视频检索:降低高维向量检索延迟;
- 推荐系统召回:提升召回效率与系统吞吐;
- 日志 / 文本相似度匹配:优化大规模向量比对性能。
常见问题
Q1:我们数据不方便外传,可以远程做吗?
可以。支持远程会议、屏幕共享和脱敏样本分析;也可以在保密协议下进行代码与架构评审。具体方式按团队安全要求协商。
Q2:多久能出方案?
取决于数据规模、问题复杂度和现有资料完整度。首次沟通后会给出一份明确的工作范围、交付物和时间表。
Q3:只做咨询,还是也能协助落地?
两者都可以。可以从索引选型、参数调优做到代码和构建流程优化,也可以只做架构评审和团队内训。
Q4:怎么验证优化效果?
以你关心的指标为准:召回率、P99 延迟、QPS、内存占用、构建时间、索引大小等。优化前后做同口径对比,避免「只看单次查询」。
Q5:支持哪些索引和场景?
Flat、HNSW、IVF、PQ、IVFPQ、HNSWPQ 等;覆盖单机、GPU 加速、分布式构建和大规模检索服务。
Q6:能提供源码标注和文档吗?
可以。根据服务范围输出流程图、源码标注、调优报告、架构方案或培训材料。
Q7:价格怎么算?
本商品为咨询启动金(9.9 元),用于预约首次需求沟通。具体项目费用会根据数据规模、问题复杂度、交付周期和服务方式单独评估。
Q8:团队内训怎么组织?
可按团队当前水平定制:FAISS 基础与进阶、向量检索原理、HNSW / IVFPQ 实战、大规模检索系统设计、性能调优方法等,支持线上或线下。
购买说明
- 支持单次咨询、项目制服务、长期顾问、团队内训;
- 可根据数据规模、问题复杂度、交付周期定制方案;
- 提供文档、流程图、源码标注、调优报告等交付物;
- 适合初创团队、中大型公司、AI 平台团队、搜索 / 推荐团队。
下一步:下单后请留下你的数据规模、当前索引类型、主要痛点和期望目标,我们会先做一次需求梳理,再确认是否进入正式咨询。
让向量检索更快、更稳、更可落地。
相关产品
千亿级分布式索引构建技术咨询|10x 提速 · 滚动建库 · 低改造成本
面向搜索、推荐、广告、向量检索等场景,提供基于 Hadoop MapReduce 的千亿级分布式索引构建咨询:架构设计、可靠性保障、滚动建库、低改造成本接入与性能优化。 ¥9.90