购物车中没有产品。
练习:用 Go 写一个并发网页爬虫
go基础 › 练习 03 · 并发爬虫 (第 3 章)
Go 的招牌是并发,用爬虫把 goroutine 与 channel 真正用起来。
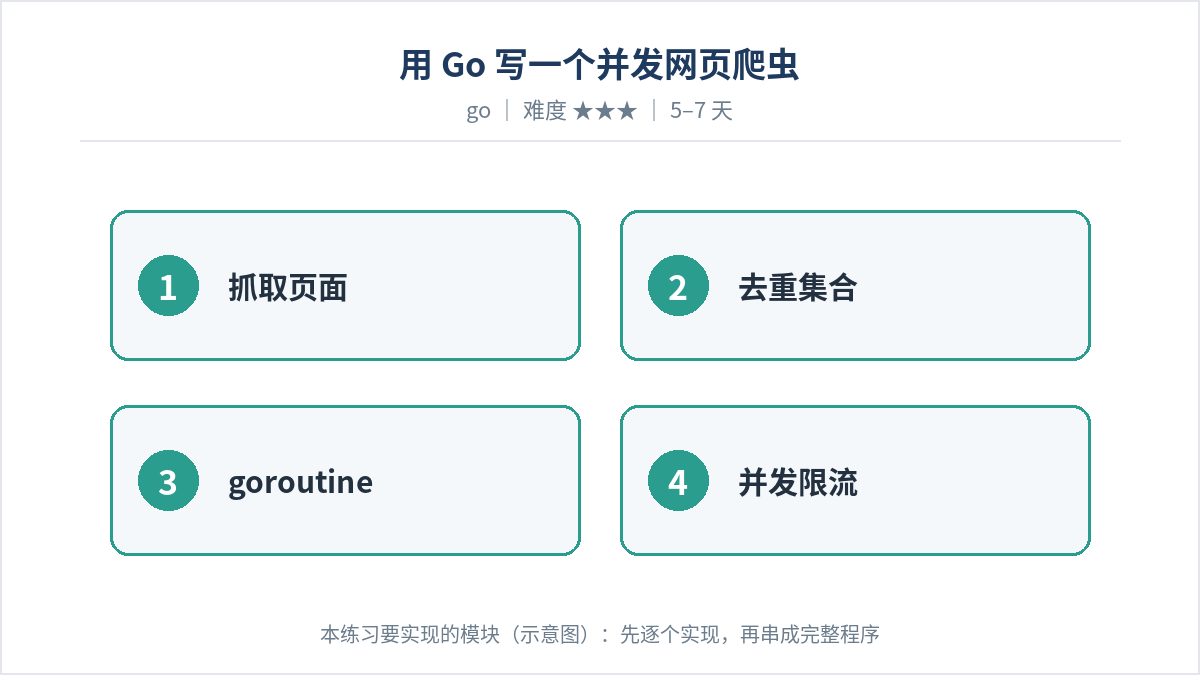
项目目标
写一个能并发抓取页面、抽取标题与链接、并把结果写入文件的小爬虫。
要做的功能
核心功能(必做)
- 用 net/http 抓取一个页面,取出标题与所有链接。
- 维护「已访问集合」(map + 锁,或 sync.Map),避免重复爬取。
- 用 goroutine + channel 并发抓取多个页面。
- 限制最大并发数(信号量 / worker pool),别把目标站打爆。
- 把结果(url + 标题)写入文件。
进阶功能(选做)
- 加请求限速与失败重试
- 做基本的 robots.txt 判断
- 统计各域名页面数量
会练到的知识点
- goroutine 与 channel
- sync 包与并发安全
- net/http
- 字符串 / 正则解析
- worker pool
验收标准
- 能并发抓取并输出结果
- 同一页面不会重复抓
- 并发数受控、能优雅退出
难度与工期
难度:★★★ · 建议工期:5–7 天 · 适合:学完语法、想练并发
参考实现(GitHub)
先自己动手实现,卡住了再对照参考;也可以只看它的目录结构,别直接照抄。
gocolly/colly —— 用 Go 写的爬虫框架,看它如何组织并发与回调。
加分项
- 结果存成 JSON 或数据库
- 加一个简单的命令行界面
- 抓取并本地生成 sitemap
建议做法:先把「核心功能」列成本地待办,每完成一项就跑一次;做完再回头看参考实现,对比自己的设计差在哪。
⚠️ 版权声明
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/10/14/practice-go-crawler/),并保留原文链接。
还没有评论,来说两句?