C++ 简介
C++ 是一门「在编译期就把类型和错误管住」的语言:它让你既写出高级的抽象,又能精确控制内存与性能。
学完你能做什么
- 用自己的话说清「静态类型、编译式、多范式」三个词的含义,并各举出一条实际好处。
- 独立编译运行一个用到
std::cout和std::vector的程序,能大致看懂报错指向哪里。 - 写出一个「数据私有、只留接口」的最小类,说明封装解决了什么问题。
- 判断「这个 C 程序能不能直接被 C++ 编译」,并说出理由,而不是笼统地说「C 是 C++ 的子集」。
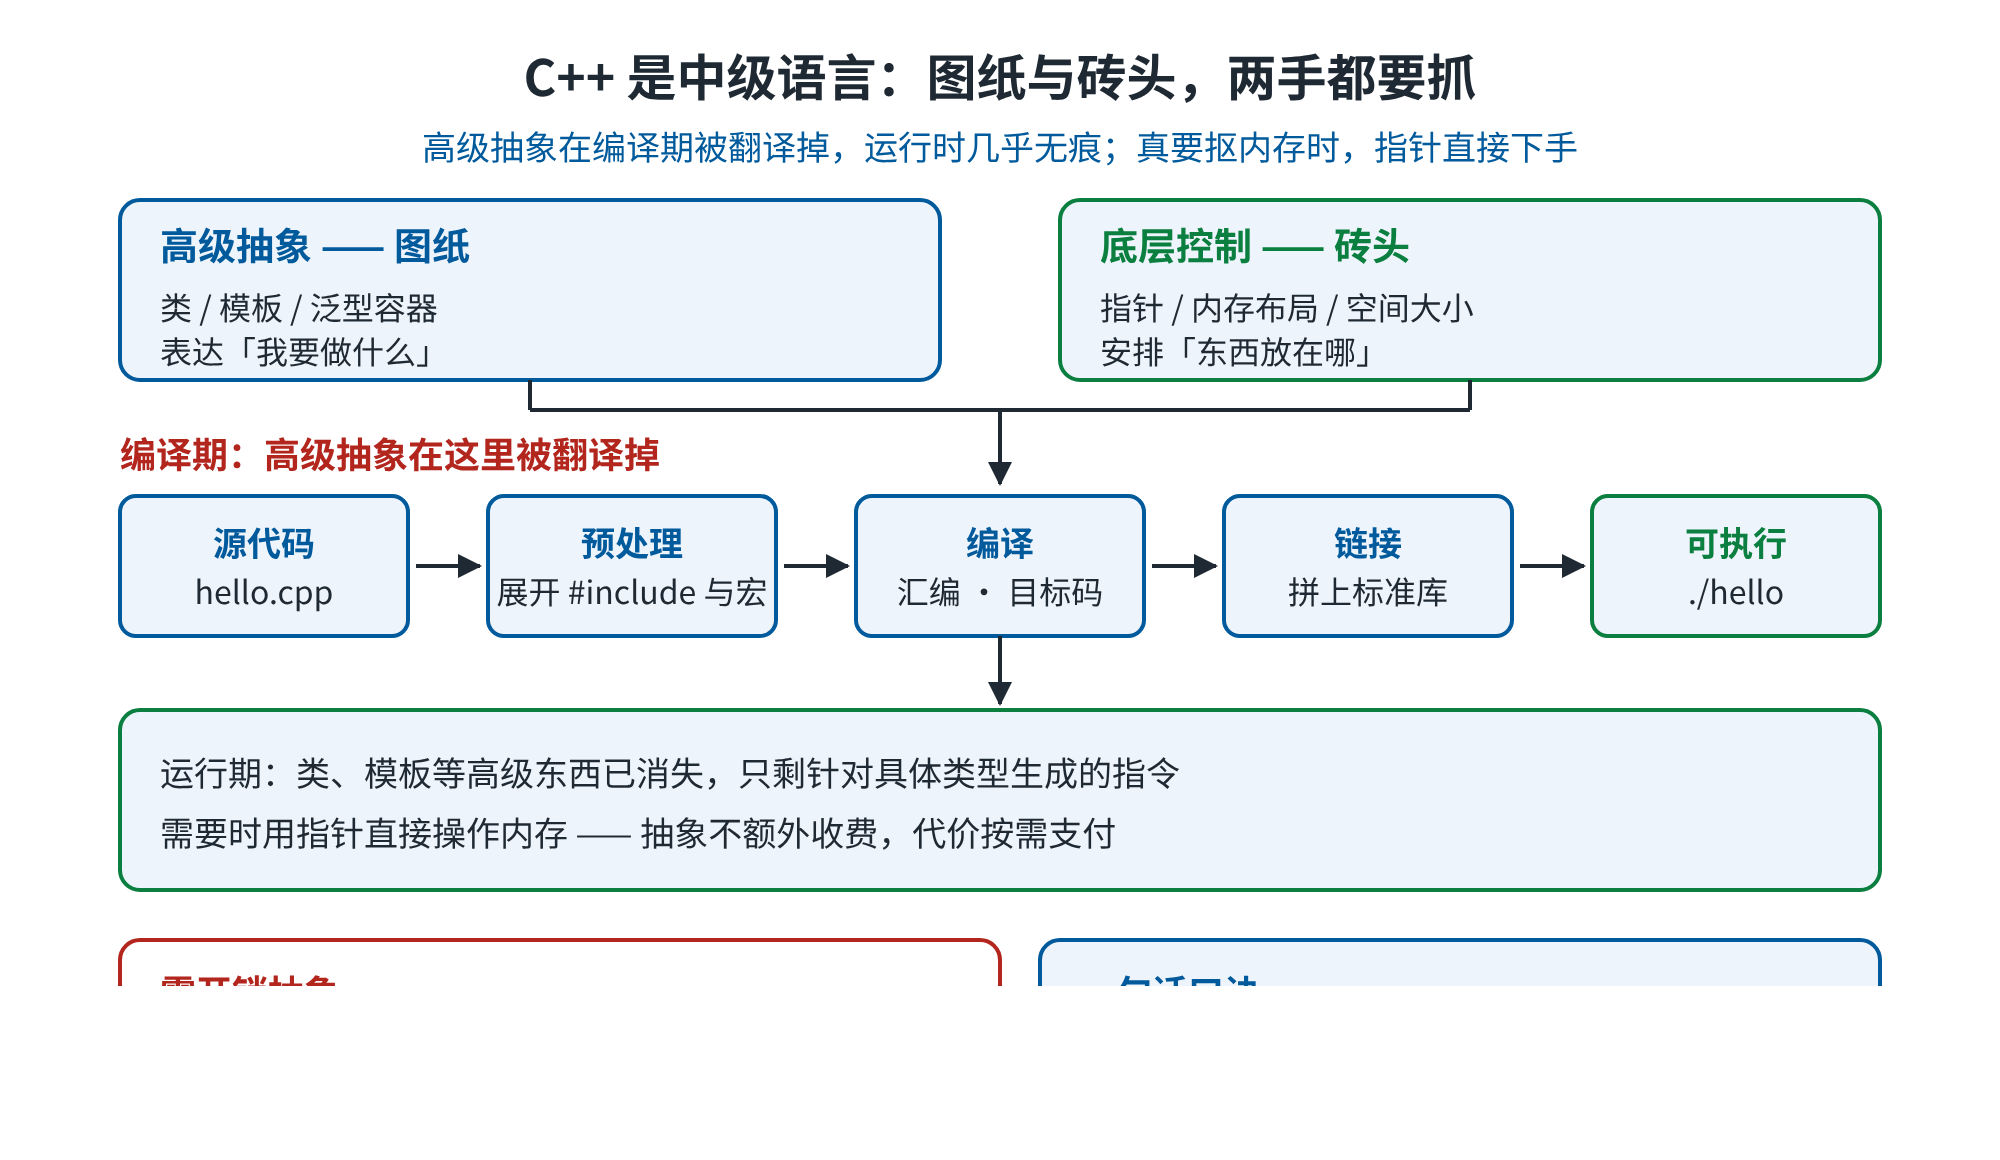
| 阶段 | 做什么 | 常见命令 | 产物 |
|---|---|---|---|
| 预处理 | 展开 #include 与宏,处理条件编译 | g++ -E hello.cpp | 展开后的源文本 |
| 编译 | 语法语义分析、类型检查,生成汇编 | g++ -S hello.cpp | 汇编 .s |
| 汇编 | 把汇编翻译成机器码 | g++ -c hello.cpp | 目标文件 .o |
| 链接 | 与其他目标码、标准库合并、解析符号 | g++ hello.o -o hello | 可执行文件 |
要点:#include 只是文本替换,包含越多、解析越久;链接阶段才把 std::cout 这类符号补上。
先建立直觉:既懂图纸,也懂砖头
写程序要同时做两件事:表达「我要做什么」,以及安排「东西放在哪、占多少空间」。
多数语言偏一边:脚本语言偏前者,机器码偏后者。C++ 两头都要抓,所以常被称作中级语言——不是「水平中等」,而是「介于高底层之间」。
它的办法是:所有「高级」的东西(类、模板)都在编译期被翻译掉,运行时几乎看不到痕迹;真需要抠内存时,又能用指针直接下手。这个思路叫零开销抽象:你不用的东西,不该让你付出代价。
从最简单的用法开始
先写一个只做一件事的程序:把变量打印出来。
▶ 在线运行:改一改再点“运行”试试(本站沙箱执行,登录后可运行)。
存成 hello.cpp,再编译运行:
g++ -std=c++17 -Wall hello.cpp -o hello
./hello预期输出:age = 20
逐句看:#include 是「把另一个文件的内容搬到这里」;int main() 是程序入口,返回 int 表示退出状态;int age = 20; 声明了一个变量,类型是 int,意思是「只能装整数」。
再往下看:为什么它快、为什么它严
一句 #include 背后是三步翻译
从 hello.cpp 到可执行文件,标准规定的过程大致是:预处理(展开 #include 和宏)→ 编译(生成汇编与目标码)→ 链接(把目标码和标准库拼起来)。
所以 #include 只是文本替换。你包含 <iostream>,编译器就得把所有声明解析一遍——这正是 C++ 编译偏慢的原因之一。这是实现层面的观察,不是某条规定。
静态类型:把检查提前到编译期
「静态类型」指变量的类型在编译时就已经确定。好处有两个:错误在编译期就被拦住,不用等程序跑起来才崩;编译器知道每个东西的类型和大小,就能直接生成针对该类型的机器指令,不必在运行时再查「这是什么类型、该怎么加」。
这就是「编译时类型检查」比「运行时类型检查」快的原因。语言规则要求类型在编译期确定;实现细节是各家编译器据此生成什么指令。代价是灵活性:类型不对就得改代码,而不能运行时临时决定。
三大块与多范式
标准 C++ 可分为:核心语言(变量、类型、函数、类这些积木)、标准库(<iostream>、<string>、<vector> 等现成工具),以及常被单独提起的 STL。严格说 STL 早已并入标准库,并列只是口语习惯。要分清:哪部分是语言规则,哪部分是库。
C++ 同时支持面向过程、面向对象、泛型三种风格。面向对象常提四件事:封装(数据藏起来,只留接口)、抽象(只暴露必要概念)、继承(复用并扩展已有类型)、多态(同一调用、不同实现)。
对比
| 维度 | C | C++ |
|---|---|---|
| 类型规则 | 较宽松(如 void* 可隐式转换) | 更严格,常需显式转换 |
| 抽象工具 | 主要靠函数和结构体 | 类、模板、命名空间等 |
| 标准库 | 较小 | 大得多,含容器与算法 |
| 典型场景 | 系统与嵌入式底层 | 底层到大型应用都覆盖 |
口诀:C 给你自由,C++ 给自由加类型;编译期多做判断,运行时少花功夫。
实战:一个会算平均分的 Student
预期输出:2 students, average = 85
看点:name_、score_ 放在 private 里,外部只能通过 score() 读——这就是封装,日后想改内部表示不会影响调用者。std::vector<Student> 是泛型容器,同一份代码能装任意类型。范围 for 加 const Student& 表示「只读,且不复制」。
| 维度 | 有符号 int | 无符号 std::size_t(v.size() 的返回类型) |
|---|---|---|
| 取值范围 | 约 ±21 亿,可为负 | 只有非负,上限约为前者两倍 |
| 与其他类型混算 | 遇到无符号操作数会被转成无符号 | 会「吞掉」有符号操作数,负数变成巨大正数 |
| 典型坑 | total / v.size() 结果可能反常 | 循环 for (unsigned i = n-1; i >= 0; --i) 永不结束 |
| 推荐写法 | 先显式转换再运算,如 total / static_cast<int>(v.size());并开启 -Wall 让编译器提醒 | |
口诀:有符号遇上无符号,小的先被抬成大的;拿不准就显式转换。
易错点(先错后对)
错法一:写 int avg = total / v.size();。v.size() 返回的是无符号类型,与 int 混用会把 total 也转成无符号:一旦 total 为负,结果会变成一个巨大的数,-Wall 也会警告。正确做法是显式转换:total / static_cast<int>(v.size())。
错法二:「C 是 C++ 的子集,所以任何 C 程序都能编过」。反例一:int n = 5; int a[n];(变长数组)在 C99 合法,但在标准 C++ 中不合法,应改用 std::vector<int> a(n);。反例二:void* p = &x; int* q = p; 在 C 中可隐式转换,C++ 必须写 static_cast<int*>(p)。原因是 C++ 的类型规则更严。
再深入一点:标准版本与未定义行为
C++ 由 ISO 标准化,版本按年份命名:C++98、C++03、C++11、C++14、C++17、C++20。每次更新都在扩充核心语言和标准库。
标准只规定「应该发生什么」,具体怎么实现由编译器决定。因此同一份代码在不同编译器、不同优化等级下表现可能不同,尤其是未定义行为:越界访问、读未初始化变量、有符号整数溢出等。这类代码不是「碰巧结果对就行」,而是整段程序的行为都没有保证——优化器可能做出你完全想不到的事。
自测练习
- 什么是静态类型?为什么「编译时检查类型」能让程序跑得更快?
- 从
.cpp到可执行文件经过哪几个阶段?为什么包含大文件会让编译变慢? - 下面两行各有什么问题:
int n = 5; int a[n];和total / v.size()?
参考答案
1. 静态类型指变量类型在编译期确定。编译器因此能在编译阶段发现类型错误,并且知道每个对象的类型与大小,可直接生成针对该类型的指令,省去运行时的类型判断与分派,所以更快。
2. 预处理(展开 #include 和宏)→ 编译(生成汇编与目标码)→ 链接(合并标准库、生成可执行文件)。#include 是文本替换,包含越多,编译器要解析的声明越多,编译越慢。
3. int a[n] 是变长数组,n 不是常量,标准 C++ 不允许,应改用 std::vector<int> a(n);。total / v.size() 是有符号与无符号混用,会触发隐式转换,应写 static_cast<int>(v.size())。
一句话记住
类型在编译期定下来,抽象在编译期消掉,代价按需支付——这就是 C++。
延伸阅读
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/09/24/cpp-intro/),并保留原文链接。
还没有评论,来说两句?