GitHub 星标 9.8k 爆火!Headroom:AI Agent 上下文无损压缩神器,Token 最高省下 95%
跑过 AI 编程、RAG 智能体的人都懂这种崩溃:一次日志检索、工具调用、文档召回,上万 Token 瞬间消耗,对话多轮后要么超窗口限额,要么月底 API 账单不忍直视。
最近 GitHub 新晋黑马项目 Headroom,上线短时间斩获 9.8k 星标,给出了颠覆性解法:在数据送入大模型前搭建一层可逆无损压缩层,对日志、代码、RAG 文本、工具返回内容智能瘦身,Token 消耗直接砍掉 60%-95%,模型回答质量零衰减,还顺带解决 KV 缓存命中率低的行业痛点。
它不只是简单摘要或粗暴截断,本地可部署、兼容 Claude、Cursor、Llama 全主流生态,今天一次性讲透它的底层逻辑、核心功能与落地价值。
一、痛点直击:为什么 AI Agent 急需上下文压缩?
当下智能体开发有三大无解开销,也是 Headroom 诞生的根源:
- 冗余数据泛滥
Agent 调用工具返回的 JSON、系统日志、代码文件、RAG 检索文档,充斥大量时间戳、重复字段、无关注释,90% 内容对当前提问无价值,但全部计入 Token 计费。Netflix 开发者实测,未优化的运维日志单次会话可产生 10 万 + Token,月度 API 成本飙升数百美元。 - KV 缓存形同虚设
Claude、OpenAI 对重复上下文前缀有 90% 缓存折扣,但工具输出里随机 ID、动态时间戳会让每轮请求前缀完全不同,缓存几乎无法命中,速度慢、开销翻倍。 - 上下文窗口瓶颈
长会话、多工具串联场景极易触达模型上下文上限,只能粗暴截断历史对话,丢失关键信息导致 AI 输出跑偏。
市面上传统方案要么牺牲信息做摘要,要么截断内容丢失上下文,而 Headroom 核心突破就是可逆无损压缩,从根源规避以上问题。
二、Headroom 核心原理:CCR 可逆压缩,压缩完还能找回原文
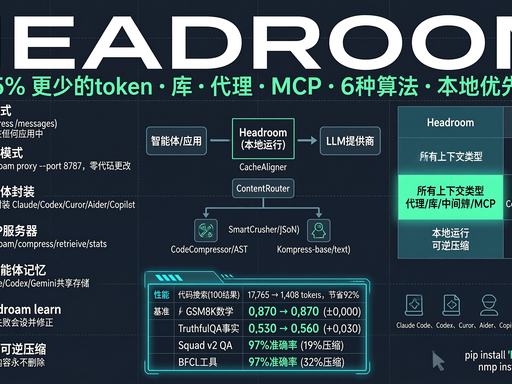
绝大多数 Prompt 压缩工具是 “一次性摘要”,压缩后原始数据永久丢失,复杂代码、长日志场景会丢失关键细节。Headroom 独创CCR(压缩 – 缓存 – 检索)机制,完整流程如下:
-
原始日志 / 代码 / RAG 文本进入压缩引擎; -
通过 6 套专用算法智能提炼核心信息,输出精简文本送入 LLM; -
完整原始内容本地持久化存储,绑定唯一 trace_id; -
当 AI 需要完整原始数据时,调用内置接口一键取回全部原文。
举个直观对比:
-
压缩前:10144 Token 完整日志 -
Headroom 压缩后:仅 1260 Token 精简上下文 -
节省比例:近 90%,且随时可还原完整日志用于排错、代码调试
内置多场景专属压缩算法,针对性优化不同数据:
-
CodeCompressor:基于 AST 语法树压缩代码,剔除注释、无效空行、重复变量; -
Kompress-base:自研大模型,专门处理 RAG 文档、自然对话; -
智能 JSON 压缩:过滤工具返回冗余字段,保留业务核心键值。
三、两大独家黑科技:CacheAligner,不止省 Token 还提速
很多人只看到 Headroom 省 Token,却忽略它内置的 CacheAligner 模块,这是拉开同类工具差距的关键。
CacheAligner 解决什么问题?
LLM 的 KV 缓存依赖稳定不变的上下文前缀,但工具输出的动态值(时间戳、UUID、随机序列号)每次都会改变前缀,缓存命中率暴跌。
优化逻辑
自动识别所有动态变量,统一替换为固定占位符,把动态内容统一后置,让系统提示词、历史对话等静态前缀完全稳定。实测效果:Claude 系列模型缓存命中率从不足 10% 提升至 85% 以上,推理延迟大幅降低,叠加平台缓存 90% 折扣,成本实现二次削减。
简单比喻:就像图书馆把每天变动的借阅数字统一挪到书页末尾,书籍主体排序永远不变,管理员(大模型)不用每次重新检索整本内容。
四、全生态兼容:本地部署,5 种接入模式覆盖所有 AI 场景
Headroom 主打本地优先,数据不会上传第三方,隐私性拉满,同时提供 5 种无侵入接入方式,新手零代码可用,开发者深度集成:
- Proxy 代理模式
修改 LLM 请求 base_url 即可全局生效,Cursor、Claude Code、CodeX 等 AI 编程工具一键接入,无需改动业务代码; - MCP 服务模式
适配新一代 Agent 标准 MCP 协议,智能体框架开箱即用; - 代码库内嵌
Python 库直接集成进自有 Agent 项目,自定义压缩规则; - 终端独立程序
本地运行客户端,手动处理文件、日志批量压缩; - 跨智能体记忆层
多 Agent 协作场景统一管理上下文缓存,全局复用压缩结果。
支持全主流大模型
Claude 全系列、OpenAI GPT、Gemini、Llama 开源模型、本地私有大模型,覆盖云端 API 与本地私有化部署场景。
五、落地价值:三类人群直接受益,行业趋势已显现
1. AI 编程开发者(Cursor/Claude Code 用户)
代码库检索、报错日志、多文件读取是 Token 消耗重灾区,压缩后单次代码查询 Token 消耗下降 70%+,长对话不会轻易丢代码上下文。
2. RAG 知识库搭建者
海量文档检索返回的冗余段落自动精简,提升检索效率,同时延长会话长度,不用频繁截断参考资料。
3. 企业 AI 智能体运维团队
Netflix 内部使用 5 个月,累计节省 2000 亿 Token 用量,直接减少 70 万美元 API 支出,高频工具调用场景降本效果最显著。
行业趋势判断
当下上下文窗口扩容成本极高,依靠更大窗口解决长文本问题性价比极低。以 Headroom 为代表的上下文中间压缩层,会成为 Agent 工程化标配:
-
短期:个人开发者、小团队用来降低 API 开销; -
长期:企业级 Agent 平台内置原生压缩模块,平衡成本、速度、上下文长度三者。
六、开源地址与上手极简步骤
GitHub 项目地址
https://github.com/tejaschopra/headroom
快速安装(Python 环境)
pip install headroom-aifrom headroom import HeadroomProxyproxy = HeadroomProxy()# 将你的Claude/OpenAI请求地址替换为本地代理地址即可自动压缩proxy.run()
总结与延伸
Headroom 跳出了 “靠更长上下文窗口解决长文本” 的内卷思路,用中间压缩层实现低成本扩容,可逆压缩 + KV 缓存双重优化是它爆火的核心竞争力。
对普通开发者而言,它是零门槛省钱工具;对企业 AI 团队,它是智能体降本增效的基础设施。随着 Agent 应用持续普及,上下文压缩大概率会成为所有 AI 工具的基础能力。
你平时跑 RAG、AI 编程时,每月 Token 开销大概多少?会尝试用上下文压缩工具降低成本吗?欢迎留言讨论。
#Headroom #AI 开发工具 #Token 省钱神器 #AIAgent #GitHub 开源项目 #大模型优化 #RAG 知识库
本文为免费文章,欢迎转载。转载请注明出处:一木科技(https://www.pingquan.vip/2026/06/23/github-%e6%98%9f%e6%a0%87-9-8k-%e7%88%86%e7%81%ab%ef%bc%81headroom%ef%bc%9aai-agent-%e4%b8%8a%e4%b8%8b%e6%96%87%e6%97%a0%e6%8d%9f%e5%8e%8b%e7%bc%a9%e7%a5%9e%e5%99%a8%ef%bc%8ctoken-%e6%9c%80%e9%ab%98/),并保留原文链接。
还没有评论,来说两句?